はじめに
2026年10月26日〜11月1日の Google Cloud データ分析カテゴリでは、Looker の MCP サーバーとデータリネージが一般提供(GA)となり、BigQuery では Connected Sheets(Google スプレッドシートから BigQuery のデータを扱う機能)での会話型分析が GA になりました。一方で、カナダの一部の州・準州のタイムゾーン変更が2026年11月1日に適用され、Cloud SQL と Looker の利用者には対処が案内されています。
本記事では、この期間に公開されたデータ分析カテゴリの更新のうち、主要な14件を取り上げます。既存の環境に影響する4件は「要対応のアップデート」に、残りの10件は日付順に「その他のアップデート詳細」にまとめ、細かな更新は末尾の「その他のアップデート」で紹介します。
IT 部門の方は、まず「要対応のアップデート」で自社の環境が該当するかをご確認ください。各トピックには、何が変わったのか、どんな業務シーンで使えるのかを整理し、公式ドキュメントへのリンクを添えています。
| 対象期間 | 2026年10月26日〜2026年11月1日 |
| 対象製品 | Google Cloud |
| 対象カテゴリ | データ分析 |
| アップデート件数 | 14件(主要トピック) |
今回のアップデート一覧
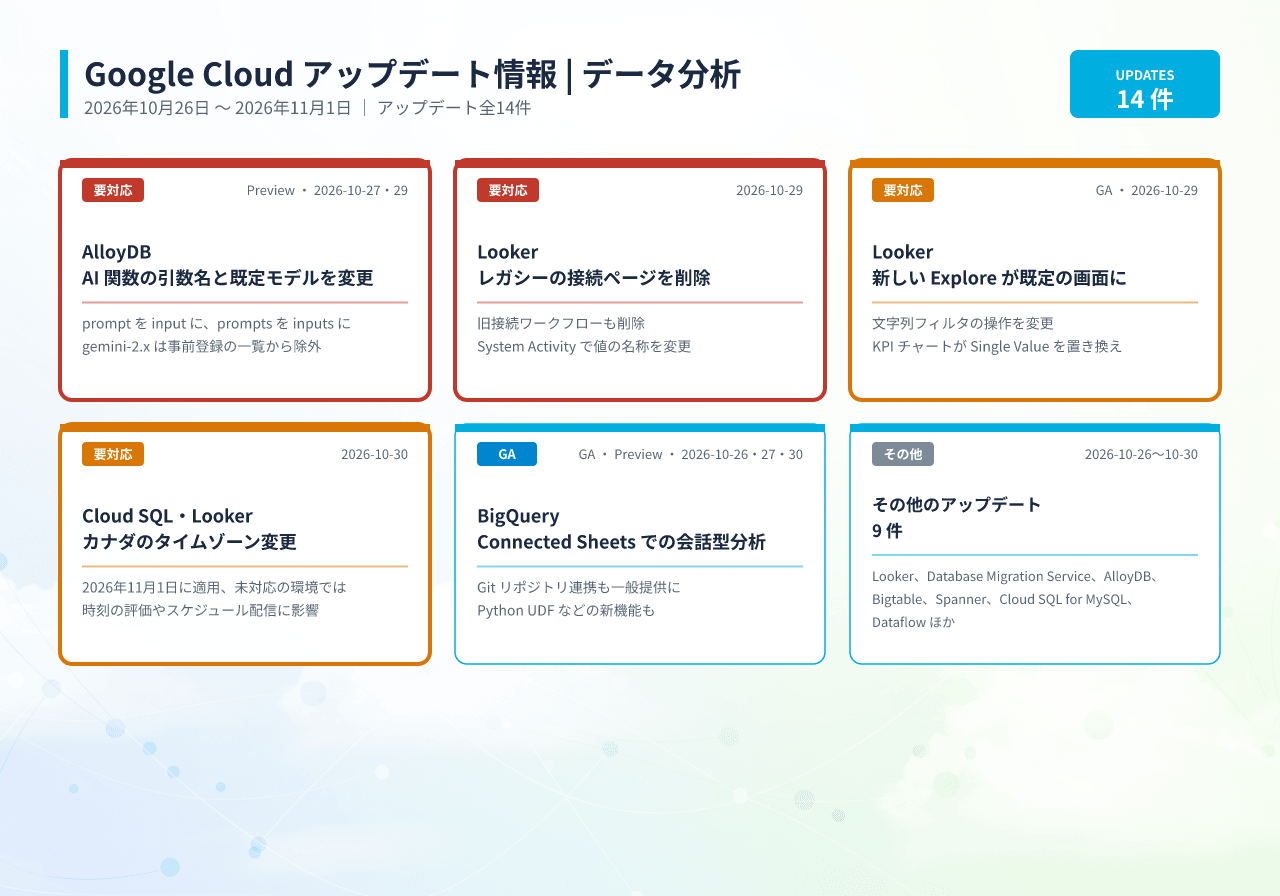
⚠️ 要対応のアップデート
1. AlloyDB — AI 関数の引数名と既定モデルの変更、gemini-2.x の各モデルが事前登録の一覧から除外(Preview・2026年10月27日・29日)
AlloyDB(Google Cloud の PostgreSQL 互換データベース)で、AI 関数の引数の名前が変わり、google_ml_integration 拡張機能の 1.6.5 では既定の Gemini モデルも変わりました。すでに AI 関数を使っている場合は変更点をご確認ください。
✨ 使えるようになる機能
この項目では、新しい機能の追加はありません。同じ期間に追加された AI 関数と引数、事前登録された新しいモデルは、「その他のアップデート詳細」の「8. AlloyDB」で紹介します。
⚠️ 使えなくなる機能 / 変更点
- AI 関数の引数の変更(10月27日・Preview): ai.analyze_sentiment、ai.summarize、ai.agg_summarize の引数名とシグネチャが更新されました。スカラー関数の prompt は input に、バッチ関数の prompts は inputs に変わり、ai.analyze_sentiment と ai.summarize のカーソルベースの版では prompt 引数が削除されました
- 既定モデルの変更(10月29日): google_ml_integration 拡張機能の 1.6.5 では既定の Gemini モデルが gemini-3.5-flash-lite になり、gemini-2.0-flash、gemini-2.0-flash-lite、gemini-2.5-flash、gemini-2.5-flash-lite、gemini-2.5-pro は事前登録の一覧から外れました
🤔 判断観点
- 影響範囲: ai.analyze_sentiment、ai.summarize、ai.agg_summarize を prompt または prompts の引数名で呼び出している SQL やアプリケーションがあるか
- 確認事項: カーソルベースの版の ai.analyze_sentiment と ai.summarize に、prompt 引数を渡している箇所があるか
- 既定モデル: google_ml_integration 1.6.5 以降で、モデルを指定せずに既定の Gemini モデルを使っている処理や、事前登録の一覧から外れた gemini-2.x のモデルを指定している処理があるか
💼 確認が必要な場面(ユースケース)
問い合わせの本文やレビューを AlloyDB に保存し、SQL の中で AI 関数を使って要約や感情分析をしているアプリケーション開発者が対象です。
📚 公式ソース
- 製品ドキュメント: Model endpoint reference(AlloyDB)
- 製品ドキュメント: Pre-registered Agent Platform models(AlloyDB)
- リリースノート: Google Cloud release notes - October 27, 2026
- リリースノート: Google Cloud release notes - October 29, 2026
2. Looker — レガシーの接続ページと旧接続ワークフローを削除、Conversational Analytics の System Activity ダッシュボードで値の名称を変更(2026年10月29日)
Looker で、データベース接続の旧来の画面と手順が削除されました。あわせて、Conversational Analytics(自然言語でデータに質問できる機能)の利用状況を表示する System Activity ダッシュボードで、一部の要素の名称が変わりました。名称の変更は、カスタム ダッシュボードの動作に影響する可能性があります。
🔍 何が変わったのか
- レガシーの接続ページ: レガシー機能「Use Legacy Connections Page」と、旧来のデータベース接続ワークフローが削除されました。すべてのデータベース接続は、公式ドキュメント「Connecting Looker to your database」で説明されている接続ワークフローを使います
- System Activity ダッシュボード: Conversational Analytics の System Activity ダッシュボードの「Token usage」タブで、「Feature」列と「Feature Name」フィルタの値 Conversational Analytics API が Looker API に変わりました。この値は、Looker API の Conversational Analytics のメソッドを指します
- ダッシュボードのレイアウトと機能は変わりません
✨ 使えるようになる機能
新しい機能の追加はありません。
⚠️ 使えなくなる機能 / 変更点
- 以前の「Feature」列や「Feature Name」フィルタの値を参照するカスタム ダッシュボードを作成している場合、今回の名称変更が破壊的変更(既存の設定が動かなくなる変更)になる可能性があると公式に記載されています
- データベース接続の作成・編集は、現行の接続ワークフローで行います
🤔 判断観点
- 影響範囲: System Activity のデータをもとに、トークン使用量を集計するカスタム ダッシュボードやレポートを作成しているか
- 確認事項: カスタム ダッシュボードのフィルタや集計条件に、値 Conversational Analytics API を指定している箇所があるか
- 運用手順: 社内の接続手順書が旧来の接続ページを前提にしていないか
💼 確認が必要な場面(ユースケース)
Conversational Analytics のトークン使用量を、System Activity のデータから独自のダッシュボードで集計している Looker 管理者が対象です。データベース接続の手順書を整備している管理者の方は、手順が現行の接続ワークフローに沿っているかを確認できます。
📚 公式ソース
- 製品ドキュメント: 管理者設定 - レガシー機能
- 製品ドキュメント: 会話型分析
- リリースノート: Google Cloud release notes - October 29, 2026
3. Looker — 新しい Explore の既定化、フィルタ操作の変更、KPI チャートへの置き換え(GA・2026年10月29日)
Looker の新しい Explore(データを選んでクエリを組み立てる画面)と merge query(複数のクエリの結果を結合する機能)の画面が一般提供(GA)となり、既定の画面になりました。あわせて、文字列フィルタでフィルタ チップを作成する操作が変わり、KPI (Single Value) チャートが従来の Single Value チャートを置き換えました。
✨ 使えるようになる機能
- 新しい Explore と merge query の画面と、KPI (Single Value) チャートを、GA の機能として利用できます
⚠️ 使えなくなる機能 / 変更点
- Explore と merge query の既定の画面: 新しい画面が、Explore と、複数のクエリのデータを結合する際の既定の画面になりました。従来の画面を既定にするレガシー機能は、「その他のアップデート詳細」の「13. Looker」で紹介します
- 文字列フィルタの操作: ダッシュボード、Look、Explore の文字列フィルタに値を入力するとき、「完了」をクリックしたり入力欄の外をクリックしたりしても、確定していないテキストからフィルタ チップが作成されなくなりました。チップを作成するには、Enter キーを押すか、カンマ(,)を入力するか、値を貼り付けます
- KPI (Single Value) チャート: 従来の Single Value チャートに代わるチャートの種類になりました
🤔 判断観点
- 影響範囲: 従来の Explore と merge query の画面を前提にした操作手順書や研修資料があるか
- 既定の画面: インスタンス全体または埋め込みの環境で、レガシー機能を使って従来の画面を既定にするか
- 利用者への案内: 文字列フィルタでチップを作成する操作(Enter キー、カンマ、貼り付け)を、ダッシュボードの利用者に案内するか
💼 確認が必要な場面(ユースケース)
Looker を全社で展開している管理者が、新しい画面への切り替えに向けて利用者の案内を準備する場面で関係します。
📚 公式ソース
- 製品ドキュメント: Explore の作成と編集
- 製品ドキュメント: 異なる Explore からの結果を統合する
- 製品ドキュメント: KPI(単一の値)グラフのオプション
- リリースノート: Google Cloud release notes - October 29, 2026
4. Cloud SQL・Looker — カナダのタイムゾーン変更が2026年11月1日に適用、未対応の環境では時刻の評価やスケジュール配信に影響(2026年10月30日)
アルバータ州、ブリティッシュコロンビア州、マニトバ州、ノースウェスト準州の一部では、2026年11月1日から夏の UTC オフセット(協定世界時との時差)を通年で使うようになりました。この変更に対応していない Cloud SQL(Google Cloud のマネージド リレーショナル データベース)と Looker の環境について、影響と対処が公式に案内されています。
🔍 何が変わったのか
- Cloud SQL for MySQL・PostgreSQL: パッチが適用されていないインスタンスで、カナダの該当するタイムゾーンを評価する場合、2026年11月1日の現地時間午前2時から時刻が1時間遅れています。インスタンスが秋の標準時への切り替えスケジュールに従ったままであるためです
- Cloud SQL for SQL Server: カナダの該当するタイムゾーンを評価するインスタンスで、同じく現地時間午前2時から時刻が1時間遅れています
- Cloud SQL では、保存済みのタイムスタンプのデータは変更されません
- Looker: パッチが適用されていないインスタンスでは、スケジュール配信の実行時刻と、now() を使う表計算に影響します。対象のタイムゾーンは America/Winnipeg、Canada/Central、America/Rainy_River、America/Edmonton、Canada/Mountain、America/Vancouver、Canada/Pacific、America/Inuvik です
✨ 使えるようになる機能
新しい機能の追加はありません。
⚠️ 使えなくなる機能 / 変更点
公式に案内されている対処は、製品ごとに次のとおりです。
| Cloud SQL for MySQL | 推奨はセルフサービス メンテナンスで最新のメンテナンス リリースに更新することです。更新後のタイムゾーン規則は *.R20260726.00_36 以降で対応しています。インスタンスを再起動できない場合の暫定策として、データベース セッションの default_time_zone フラグを固定の数値オフセット(アルバータは '-06:00'、ブリティッシュコロンビアは '-07:00'、マニトバは '-05:00')に設定する方法が案内されており、インスタンスのダウンタイムは発生しません |
| Cloud SQL for PostgreSQL | 推奨はセルフサービス メンテナンスで最新のメンテナンス リリースに更新することです。更新後のタイムゾーン規則は *.R20260712.01_44 以降で対応しています。暫定策として、ALTER DATABASE 文でデータベースのタイムゾーンを固定オフセットのアンカーゾーン(アルバータとノースウェスト準州は 'America/Regina'(UTC-6)、ブリティッシュコロンビアは 'America/Whitehorse'(UTC-7)、マニトバは 'America/Coral_Harbour'(UTC-5))に設定する方法が案内されており、ダウンタイムなしで設定できます |
| Cloud SQL for SQL Server | Microsoft のガイダンスに沿って、各インスタンスのタイムゾーンを、同じ固定オフセットを持つ Windows のタイムゾーンに変更します。ブリティッシュコロンビアは Pacific Standard Time から Yukon Standard Time(UTC-07:00)へ、アルバータとイヌヴィク(ノースウェスト準州)は Mountain Standard Time から Canada Central Standard Time(UTC-06:00)へ、マニトバは Central Standard Time から Eastern Standard Time (Mexico)(UTC-05:00)へ変更します。Google Cloud コンソール(Edit instance > Flags and parameters > Time zone)か、gcloud CLI の gcloud sql instances patch コマンドの --time-zone オプションで変更できます |
| Looker | パッチ適用済みの Looker ビルドへのアップグレードか、スケジュール配信に別のタイムゾーンを設定する方法が、公式ドキュメント「2026 Canadian time zone changes」で案内されています。パッチ適用済みのビルドで更新されるのはスケジューラー(Ruby)とブラウザ(JavaScript)のタイムゾーン データです。サーバー側の JVM で評価される now() の表計算は、引き続き同梱の JDK のタイムゾーン データベース(tzdb 2026b)を使います |
🤔 判断観点
- 影響範囲: カルガリー、エドモントン、バンクーバー、ウィニペグなど、該当する地域のタイムゾーンで時刻を計算・スケジュール・表示しているアプリケーションやレポートがあるか
- 適用状況: Cloud SQL for MySQL・PostgreSQL のメンテナンス リリースが、上記の版以降になっているか
- 暫定策の要否: 再起動できないインスタンスに、ダウンタイムを伴わない暫定策(MySQL のフラグ、PostgreSQL の ALTER DATABASE)を適用するか
- Looker の表計算: パッチ適用後も、サーバー側で評価される now() の表計算は同梱の tzdb 2026b を使うため、該当するタイムゾーンを使う表計算の結果を確認するか
💼 確認が必要な場面(ユースケース)
カナダの拠点や顧客のデータを Cloud SQL で扱い、データベースの関数で現地時刻を計算・表示しているアプリケーションの運用担当者が対象です。Looker でカナダのタイムゾーンを指定してダッシュボードを定期配信している BI 管理者の方も、配信時刻を確認する必要があります。
📚 公式ソース
- 製品ドキュメント: 2026 年のカナダのタイムゾーンの変更
- リリースノート: Google Cloud release notes - October 30, 2026
その他のアップデート詳細
5. BigQuery — Connected Sheets での会話型分析と Git リポジトリ連携が一般提供に、Python UDF などの新機能も(GA・Preview・2026年10月26日・27日・30日)
BigQuery(Google Cloud のデータウェアハウス サービス)で、会話型分析、開発、SQL 関数に関する複数の機能が追加されました。10月26日と27日に GA となった機能と、Previewとして公開された機能があります。
🔍 何が変わったのか
- 会話のログ記録(10月26日・GA): BigQuery の会話型分析で、データ エージェントとの会話を、エージェントのプロジェクト内の BigQuery テーブルに記録できます
- Connected Sheets での会話型分析(10月27日・GA): Gemini のサイドパネルが、自然言語の質問を最適化された SQL クエリに変換して実行し、主な傾向の要約や、更新可能なデータベース オブジェクトのワークブックへの挿入を行います
- BigQuery Studio の Git リポジトリ(10月27日・GA): SQL スクリプトとノートブックを、フォルダ単位でリモートの Git リポジトリと連携させ、管理・バージョン管理できます
- Data Engineering Agent の Google ドライブ連携(10月27日・GA): Google スプレッドシートのファイル、CSV、JSONL のファイルを、データ エンジニアリングのパイプラインの入力として渡せます
- AI.COUNT_TOKENS 関数(10月27日・GA): テキストの文字列のトークン数(生成 AI がテキストを処理する単位の数)を推定します
- Python UDF のボリューム マウント(10月26日・Preview): Python のユーザー定義関数(UDF)のコードから、Cloud Storage にある依存ファイルに直接アクセスできます
- REGEXP_EXTRACT_GROUPS 関数(10月26日・Preview): 正規表現の複数のキャプチャ グループに一致する部分文字列を取り出します
- Apache Arrow 形式での結果の取得(10月30日・Preview): クエリ結果を Apache Arrow 形式で直接取得でき、取得の速度とシリアル化の効率が向上します
💼 こんな場面で活用できます(ユースケース)
スプレッドシートで集計作業をしている業務部門の担当者が、BigQuery のデータに自然言語で質問し、その結果を更新可能な形でシートに取り込む場面で使えます。データ エンジニアは、分析用の SQL スクリプトやノートブックを Git で管理し、変更履歴をチームで共有できます。
✨ 導入メリット
- SQL を書かない担当者も、使い慣れたスプレッドシートから BigQuery のデータを分析できます
- データ エージェントとの会話を BigQuery のテーブルに残せるため、エージェントの利用状況を記録できます
- SQL スクリプトとノートブックをバージョン管理でき、変更内容をたどれるようになります
📚 公式ソース
- 製品ドキュメント: 会話ロギングの概要
- リリースノート: Google Cloud release notes - October 26, 2026
- リリースノート: Google Cloud release notes - October 27, 2026
- リリースノート: Google Cloud release notes - October 30, 2026
6. Looker — Looker が管理する MCP サーバーと Looker (Google Cloud core) のデータリネージが一般提供に(GA・2026年10月26日)
Looker で、AI エージェントとの連携とデータ ガバナンスに関わる2つの機能が一般提供(GA)になりました。Looker が管理する MCP サーバー(Model Context Protocol。AI エージェントが外部のデータやツールにアクセスするための共通の仕組み)と、Knowledge Catalog(旧 Dataplex Universal Catalog。データ資産のメタデータを管理するカタログ)のデータリネージ(データの出どころと流れの記録)における Looker (Google Cloud core) への対応です。
🔍 何が変わったのか
- MCP サーバー: AI エージェントは、追加のミドルウェアを用意しなくても、ビジネスデータと LookML モデル(Looker でデータの定義を記述したモデル)に安全にアクセスできます
- Manage OAuth Clients: 新しい管理ページが追加され、AI エージェントや外部アプリケーションの、ID に基づくアクセスを1か所で管理できます。管理者は、Application Library から設定済みの連携を有効にするか、リダイレクト URI とグループ単位のアクセス制御を指定して独自の OAuth クライアントを登録できます
- データリネージ: LookML のビューと Explore、Looker のダッシュボードとその要素、Look、LookML ダッシュボード、Conversational Analytics のエージェントのリネージを表示できます。BigQuery のデータソースから Looker のセマンティック レイヤー(指標や項目の定義を集約した層)を経て、下流の資産に至るデータの流れを可視化できます
- リネージの取り込みを、組織、フォルダ、プロジェクトの単位で制御できます。リネージの有効化は、Data Lineage API とサービス単位の取り込み制御で管理するようになり、Looker 内部の Knowledge Catalog のメタデータ設定とは切り離されました
💼 こんな場面で活用できます(ユースケース)
社内の AI エージェントから Looker のデータと LookML モデルを参照させたい開発者が、MCP サーバーを使えます。Looker 管理者は、どの AI エージェントや外部アプリケーションに、どのグループのアクセスを許可するかを管理ページで設定できます。データ管理部門の担当者は、BigQuery のテーブルから Looker のダッシュボードや Conversational Analytics のエージェントまでのデータの流れを、カタログ上で確認できます。
✨ 導入メリット
- AI エージェントとの連携に、ミドルウェアを別途用意する必要がありません
- AI エージェントや外部アプリケーションのアクセスを、グループ単位の制御を含めて管理ページで一元的に管理できます
- 取り込みの範囲を組織・フォルダ・プロジェクトの単位で決められ、データ ガバナンスの方針に合わせて運用できます
📚 公式ソース
- 製品ドキュメント: Looker が管理する MCP サーバー
- 製品ドキュメント: 管理者設定 - OAuth クライアントの管理
- 製品ドキュメント: Knowledge Catalog でデータリネージを追跡する
- リリースノート: Google Cloud release notes - October 26, 2026
7. Database Migration Service — スキーマ変換で移行元との直接のネットワーク接続が不要に、SQL Server の分散可用性グループ(DAG)による移行が一般提供に(2026年10月26日・28日)
Database Migration Service(データベースを Google Cloud に移行するサービス)で、異なる種類のデータベース間の移行と、SQL Server 同士の移行の両方に機能が追加されました。
🔍 何が変わったのか
- Cloud Storage からのスキーマ メタデータの取り込み(10月26日): 異種データベース間の変換ワークスペースを、Cloud Storage のバケットにあるスキーマのメタデータ ファイルを取り込んで作成できます。スキーマ変換の段階で、Database Migration Service と移行元のデータベースを直接ネットワークで接続する必要はありません。対象は、Oracle から Cloud SQL for PostgreSQL・AlloyDB for PostgreSQL への移行と、SQL Server から Cloud SQL for PostgreSQL・AlloyDB for PostgreSQL への移行です
- 分散可用性グループ(DAG)による移行(10月28日・GA): SQL Server 同士の移行で、gcloud CLI と Database Migration Service API を使い、自己管理の SQL Server Enterprise Edition から Cloud SQL for SQL Server へ、プライベート ネットワーク経由で直接移行できます
- DAG による移行では、バックアップやトランザクション ログのファイルを Cloud Storage に書き出す必要がありません。昇格後の逆方向のレプリケーションに対応し、データを失わずに切り戻せます
💼 こんな場面で活用できます(ユースケース)
オンプレミスの Oracle や SQL Server を PostgreSQL 系のデータベースへ移行する計画を立てている IT 部門が、移行元との接続環境を整える前にスキーマ変換を始める場面で使えます。SQL Server を Cloud SQL for SQL Server へ移行する担当者は、切り戻しの手段を確保したまま移行を進められます。
✨ 導入メリット
- 移行元とのネットワーク接続を用意する前に、スキーマ変換の作業を始められます
- DAG による移行では、バックアップ ファイルの書き出しと転送の手順が不要になります
- 昇格後も逆方向のレプリケーションで、データを失わずに切り戻せます
📚 公式ソース
- 製品ドキュメント: Cloud Storage に保存されているスキーマ ファイルを使用する
- 製品ドキュメント: 分散可用性グループを使用してセルフマネージド SQL Server から移行する
- リリースノート: Google Cloud release notes - October 26, 2026
- リリースノート: Google Cloud release notes - October 28, 2026
8. AlloyDB — ベクトル検索の強化と IAM グループ認証が一般提供に、AI 関数の追加も(GA・Preview・2026年10月27日〜29日)
AlloyDB で、AI 関数、ベクトル検索、認証に関する機能が追加されました。既存の AI 関数の引数名と既定モデルの変更は、「⚠️ 要対応のアップデート」の「1. AlloyDB」で紹介しています。
🔍 何が変わったのか
- 新しい AI 関数(10月27日・Preview): 非構造化テキストから構造化データを取り出す ai.extract と、テキストを指定したラベルに分類する ai.classify を、データベースのクエリの中で使えます
- AI 関数の引数の追加(10月27日・Preview): ai.summarize と ai.agg_summarize には、要約の形式・長さ・トーンを指示する任意の additional_instructions 引数が加わりました
- IAM グループ認証(10月28日・GA): PostgreSQL 15 以降のクラスタで、データベースのロールと権限をグループ単位で管理できます。プライマリ インスタンスと読み取りプール インスタンスの両方が対象で、読み取りプール インスタンスへの初回のサインインにも対応します。Cloud SQL for PostgreSQL のバックアップから移行するときに、個別ユーザーと IAM グループ ユーザーの設定を引き継げます
- ベクトル検索(10月28日・GA): PostgreSQL 17 以降で、4階層ツリー(4LT)の ScaNN ベクトル インデックスにより最大100億行のベクトルを扱えます。4LT のインデックスは自動のインデックス メンテナンスに対応し、num_leaves の上限は 30,000,000 から 104,857,600 に引き上げられました。scann.satisfy_limit を relaxed_order に設定すると、LIMIT 句を満たす件数が見つかるまで探索が続き、フィルタ付き検索の再現率が向上します
- Vector assist(10月28日・GA): 埋め込みの生成、クエリの最適化、HNSW などのインデックス作成を含め、本番向けのベクトル検索の設定を支援します
- 外部検索と全文検索(10月28日・GA): external_search_fdw 拡張機能で、Elasticsearch、Solr、OpenSearch のデータをデータベースから直接クエリできます。PostgreSQL 17 以前では rum 拡張機能を使い、フレーズ検索や関連度の順位付けを高速に行えます
- Gemini モデルの事前登録(10月29日): google_ml_integration 拡張機能の 1.6.5 以降で、gemini-3.1-flash-lite、gemini-3.5-flash、gemini-3.5-flash-lite、gemini-3.6-flash、gemini-3.7-flash、gemini-3.8-flash、gemini-4-argon と、再ランキング モデルの semantic-ranker-512 が事前登録されました
💼 こんな場面で活用できます(ユースケース)
問い合わせの本文やレビューを AlloyDB に保存しているアプリケーション開発者が、SQL の中で本文を分類したり、項目を取り出したりする場面で使えます。大量の商品データや文書をベクトル化して類似検索を提供している場合は、100億行規模までのインデックスと自動メンテナンスを使えます。データベース管理者は、社員の権限を IAM のグループ単位で付与できます。
✨ 導入メリット
- テキストの分類や抽出のために、外部の処理パイプラインを用意する必要がありません
- 大規模なベクトル検索でも、インデックスの保守を自動化できます
- データベースのロールと権限を、ユーザーごとではなく IAM のグループ単位で管理できます
📚 公式ソース
- 製品ドキュメント: AlloyDB for PostgreSQL の IAM データベース認証
- 製品ドキュメント: ベクトル アシストの概要
- 製品ドキュメント: Pre-registered Agent Platform models(AlloyDB)
- リリースノート: Google Cloud release notes - October 27, 2026
- リリースノート: Google Cloud release notes - October 28, 2026
- リリースノート: Google Cloud release notes - October 29, 2026
9. Bigtable — マイクロ秒単位のタイムスタンプと Knowledge Catalog での検出が一般提供に、Avro データのクエリも(GA・Preview・2026年10月27日・28日・30日)
Bigtable(大量のデータを低レイテンシで読み書きする Google Cloud の NoSQL データベース)で、データの格納とクエリ、データ資産の検出に関する機能が追加されました。
🔍 何が変わったのか
- Apache Avro のスキーマ バンドル(10月27日・Preview): Bigtable にシリアル化されたバイト列として保存した Avro レコードの個々のフィールドを、GoogleSQL for Bigtable、継続的マテリアライズド ビュー、論理ビューでクエリできます
- マイクロ秒単位のタイムスタンプ(10月28日・GA): セルのタイムスタンプをマイクロ秒の精度で保存するようにテーブルを設定でき、イベントの頻度が高いワークロードで書き込みの衝突によるデータの消失を防げます。対象は Enterprise Plus エディションのインスタンスです
- Knowledge Catalog での検出(10月30日・GA): 承認済みビュー、論理ビュー、継続的マテリアライズド ビューを、Bigtable のインスタンスやテーブルとあわせて Knowledge Catalog で検索できます
💼 こんな場面で活用できます(ユースケース)
センサーや取引のイベントを高い頻度で Bigtable に書き込んでいるデータ エンジニアが、同じ時刻の書き込みが衝突してデータを失う事態を避ける場面で使えます。Avro レコードをバイト列として Bigtable に保存しているチームは、レコード内の個々のフィールドを GoogleSQL for Bigtable でクエリできます。
✨ 導入メリット
- 高頻度のデータでも、書き込みの衝突によるデータの消失を防げます
- シリアル化された Avro レコードの個々のフィールドを、SQL で直接クエリできます
- ビューもカタログで検索でき、利用者が目的のデータを探しやすくなります
📚 公式ソース
- 製品ドキュメント: Avro スキーマを作成して管理する
- 製品ドキュメント: Avro データをクエリする
- 製品ドキュメント: Knowledge Catalog を使用してデータアセットを管理する
- リリースノート: Google Cloud release notes - October 27, 2026
- リリースノート: Google Cloud release notes - October 28, 2026
- リリースノート: Google Cloud release notes - October 30, 2026
10. Spanner — 外部キーの ON DELETE SET NULL と、JSON の比較・並べ替えに対応(2026年10月27日・30日)
Spanner(Google Cloud のグローバル分散データベース)で、外部キーの動作と JSON データの扱いに関する機能が追加されました。
🔍 何が変わったのか
- ON DELETE SET NULL(10月27日): GoogleSQL と PostgreSQL の両方の言語で、外部キーの動作として ON DELETE SET NULL を使えます。参照先の行を削除すると、参照元の列が NULL に設定されます
- JSON の比較と並べ替え(10月30日): JSONB と JSON の値で、等価の比較と順序の比較ができます。ほかのデータ型に変換しなくても、GROUP BY 句と ORDER BY 句で使えます
- GoogleSQL では、CAST(expression AS JSON) でほかのデータ型を JSON に変換でき、JSON の値と JSON 以外の値を直接比較できます。比較の際、JSON 以外の値は暗黙に JSON に変換されます
- 検索インデックスを使って、JSONB と JSON の列やそのサブパスに対する = や IN の比較を高速化できます
💼 こんな場面で活用できます(ユースケース)
顧客と担当者のように参照関係のあるテーブルを Spanner で管理しているアプリケーション開発者が、担当者の行を削除したときに顧客の行は残したまま参照だけを外す場面で使えます。属性を JSON で保存している場合は、その値で集計や並べ替えを行えます。
✨ 導入メリット
- 参照先の削除にあわせて参照元の列を NULL にする処理を、アプリケーション側で書く必要がありません
- JSON の値を別の型に変換する手間なく、集計や並べ替えに使えます
📚 公式ソース
- 製品ドキュメント: 外部キーのアクション
- リリースノート: Google Cloud release notes - October 27, 2026
- リリースノート: Google Cloud release notes - October 30, 2026
11. Cloud SQL for MySQL — 読み取りレプリカの再作成後もセカンダリ インデックスを自動で再構築する、マネージド レプリカ インデックスが一般提供に(GA・2026年10月28日)
Cloud SQL for MySQL で、マネージド レプリカ インデックスが一般提供(GA)になりました。Cloud SQL が読み取りレプリカを再作成したときに、レプリカだけに定義したセカンダリ インデックスを自動で保持・復元できます。
🔍 何が変わったのか
- これまでは、読み取りレプリカを再作成すると、独自に追加したセカンダリ インデックスが削除されていました。プライマリのバックアップには、レプリカだけのインデックスの定義が含まれないためです
- マネージド レプリカ インデックスでは、Cloud SQL がプライマリ インスタンスでセカンダリ インデックスのメタデータを管理し、読み取りレプリカに複製します。レプリカの再作成後には、セカンダリ インデックスが自動で再構築されます
- 対象は、Cloud SQL for MySQL 8.0 以降、Cloud SQL Enterprise エディションまたは Enterprise Plus エディション、メンテナンス バージョン R20260726.00_05 以降のインスタンスです
💼 こんな場面で活用できます(ユースケース)
読み取りレプリカだけにセカンダリ インデックスを追加している Cloud SQL for MySQL の運用担当者が使えます。これまではレプリカの再作成でこれらのインデックスが削除されていましたが、再作成後に自動で再構築されるようになります。
✨ 導入メリット
- レプリカが再作成されても、レプリカだけに定義したセカンダリ インデックスが自動で再構築されます
📚 公式ソース
- 製品ドキュメント: リードレプリカのインデックスを作成して管理する
- リリースノート: Google Cloud release notes - October 28, 2026
12. Dataflow — Streaming Engine のジョブで、自動スケーリングにレイテンシ階層とスケジュールを設定可能に(2026年10月29日)
Dataflow(ストリーミング・バッチのデータ処理パイプラインを実行するサービス)で、Streaming Engine を使うジョブの水平自動スケーリング(処理量に応じてワーカー数を増減する機能)を調整する機能が2つ追加されました。
🔍 何が変わったのか
- レイテンシ階層: low_latency、medium_latency、high_latency から階層を選んで、バックログ(未処理のデータ)のしきい値を設定できます。バックログの滞留時間に対する自動スケーリングの感度を決め、レイテンシの要件とリソースのコストのバランスをとれます
- 自動スケーリングのスケジュール: 特定の時間帯に、最小・最大のワーカー数、ワーカー使用率のヒント、レイテンシ階層などのパラメータを上書きする定期スケジュールを設定できます
- どちらの機能も、ジョブの作成時に設定でき、実行中のジョブでも更新できます
💼 こんな場面で活用できます(ユースケース)
日中と夜間でデータの流入量が変わるストリーミング パイプラインを運用しているデータエンジニアが、業務時間帯だけワーカー数の下限を引き上げる場面で使えます。多少の遅れを許容できる集計処理では、レイテンシ階層を選んでリソースのコストを抑える設定ができます。
✨ 導入メリット
- 処理の遅延の許容度に合わせて自動スケーリングの感度を選べ、コスト最適化につなげられます
- 時間帯ごとのパラメータの上書きを、定期スケジュールで自動的に適用できます
- 実行中のジョブでも設定を更新でき、パイプラインを止めずに調整できます
📚 公式ソース
- 製品ドキュメント: ストリーミング パイプラインの水平自動スケーリングを調整する - Set the latency tier
- 製品ドキュメント: ストリーミング パイプラインの水平自動スケーリングを調整する - Schedule autoscaling changes
- リリースノート: Google Cloud release notes - October 29, 2026
13. Looker — Explore と merge query を従来の画面で開くレガシー機能を追加、Looker (Google Cloud core) に「Legacy features」ページも(2026年10月29日)
Looker で、管理者が Explore と merge query の従来の画面を既定に設定するためのレガシー機能が追加されました。新しい画面が既定になった変更は、「⚠️ 要対応のアップデート」の「3. Looker」で紹介しています。
🔍 何が変わったのか
- Looker (original) と Looker (Google Cloud core) に、2つのレガシー機能「Use Legacy Explore and Merge Query Experience」と「Use Legacy Explore and Merge Query Experience for Embed」が追加されました。管理者は、インスタンス全体または埋め込みの環境で、Explore と merge query を従来の画面で開くように設定できます
- Looker (Google Cloud core) のインスタンスの管理パネルに、「Legacy features」ページが追加されました。表示されるレガシー機能は、Looker (original) のインスタンスで使えるものと異なる場合があります
💼 こんな場面で活用できます(ユースケース)
従来の画面を前提にした操作手順書や研修資料がある場合、Looker の管理者は、レガシー機能で従来の画面を既定にしたうえで、移行の時期を計画できます。
✨ 導入メリット
- レガシー機能により、インスタンス全体と埋め込みの環境で、それぞれ既定の画面を選べます
- Looker (Google Cloud core) でも、管理パネルからレガシー機能を確認できるようになりました
📚 公式ソース
- 製品ドキュメント: 従来の Explore とマージクエリ エクスペリエンスを使用する
- 製品ドキュメント: 埋め込みに以前の Explore と「クエリを結合」エクスペリエンスを使用する
- 製品ドキュメント: Looker(Google Cloud コア)管理設定
- リリースノート: Google Cloud release notes - October 29, 2026
14. Looker — Visualization Assistant と Gemini による Explore の要約が一般提供に、ブレット・ヒストグラムのチャートも追加(GA・Preview・2026年10月29日)
Looker で、可視化と Gemini による支援の機能が追加されました。Gemini in Looker の機能である Visualization Assistant と、Explore の要約の生成が一般提供(GA)になり、新しいチャートの種類も加わっています。
🔍 何が変わったのか
- Visualization Assistant(GA): 自然言語の指示を可視化の書式設定に変換し、プレビューして適用できる機能です。Highcharts ベースの可視化(多くのデカルト座標のチャートなど)が対象です
- Gemini による Explore の要約(GA): Gemini の支援で、Explore の内容の要約を生成できます
- ブレット チャート(GA): 主要な指標の実績を棒で、目標を目標線で示し、「poor」「satisfactory」「good」などの評価の範囲を背景の網掛けで表せます
- ヒストグラム チャート: 値を区間(ビン)に分け、各区間に含まれる値の数を数えて、データの分布を表すチャートが追加されました
- Table Row Grouping(GA): 表のチャートのデータを、グループごとに階層的に表示し、見た目をカスタマイズできます
- Dashboard Tile Groups(Preview): 関連するタイルを折りたためるコンテナにまとめ、ニュースペーパー レイアウトのダッシュボードで、複数のタイルを1つの単位として移動・複製・削除できます。LookML でタイルのグループを管理することもできます
💼 こんな場面で活用できます(ユースケース)
月次の業績ダッシュボードを作成している経営企画の担当者が、売上の実績と目標をブレット チャートで並べて表示する場面で使えます。ダッシュボードの作成者は、Visualization Assistant に自然言語で書式を指示し、チャートの見た目を整えられます。
✨ 導入メリット
- 目標に対する達成度やデータの分布を、専用のチャートで表せます
- チャートの書式設定を自然言語で指示し、プレビューで確かめてから適用できます
- タイルをグループにまとめることで、項目の多いダッシュボードを整理できます
📚 公式ソース
- 製品ドキュメント: Gemini の支援機能を使用してビジュアリゼーションを作成する
- リリースノート: Google Cloud release notes - October 29, 2026
その他のアップデート
上記のほかに、今回の期間には次のアップデートが公開されました。
- Memorystore for Redis Cluster(2026年10月28日): 基本的なトークンベースの認証が GA になりました。(公式ドキュメント)
- Looker(2026年10月29日): Looker の継続的インテグレーション(CI)が hub-and-spoke 構成のプロジェクトに対応しました。上流のハブ プロジェクトで pull request が作成・更新されると、ローカル プロジェクト インポートで取り込んでいる下流のスポーク プロジェクトのテストが実行され、マージ前に Explore やコンテンツへの影響を確認できます。(公式ドキュメント)
- Looker(2026年10月29日): データベース接続のテストが失敗すると、接続先の DNS の名前解決と TCP 接続が自動でテストされ、結果がエラー メッセージに追加されるようになりました。管理者は「Connections」ページの「Test Reachability」で、接続を作成せずに任意のホスト名とポートへの到達性を確認できます。(公式ドキュメント)
- Looker(2026年10月29日): インスタンスで利用できる機能、動作の変更、不具合の修正を確認できる Release Changelog が Preview として公開されました。(公式ドキュメント)
- AlloyDB(2026年10月30日): PostgreSQL 18 以降と互換のクラスタでは、Advanced Query Insights の設定を有効化・編集するときに、インスタンスの再起動が不要になりました。PostgreSQL 17 以前と互換のクラスタでは、引き続き再起動が必要です。(公式ドキュメント)
- Datastream(2026年10月30日): Knowledge Catalog との連携が GA になりました。(公式ドキュメント)
まとめ
2026年10月26日〜11月1日のデータ分析カテゴリでは、カナダのタイムゾーン変更が11月1日に適用され、Cloud SQL と Looker の利用者には製品ごとの対処が案内されています。また、AlloyDB の AI 関数の引数名と既定モデル、Looker の Explore の既定の画面と文字列フィルタの操作も変わりました。機能面では、Looker の MCP サーバーとデータリネージ、BigQuery の Connected Sheets での会話型分析、AlloyDB のベクトル検索の強化が GA となりました。IT 部門の方は要対応の4件で自社環境の該当有無を、データ活用を進める部門の方は AI エージェントとの連携に関わる Looker と BigQuery の更新を、それぞれ確認できます。
関連 XIMIX 記事
Google Cloud アップデート情報をシリーズでご覧になりたい方は、アップデート情報一覧から過去の記事もご確認いただけます。
- [Google Cloud Next '25 Las Vegas] セッション参加レポート: AIエージェントによるBQデータパイプラインの自動化
- [Google Cloud Next '26 Las Vegas] 現代のアプリケーションとAIのためのNoSQL:Memorystore、Firestore、Bigtableの未来
XIMIX からのご案内
XIMIX(サイミクス)は NI+C が運営する Google Cloud プレミアパートナーサービスです。Google Cloud / Google Workspace の導入・活用支援、データ活用、AI 活用などをご支援しています。本記事で取り上げた BigQuery や Looker、AlloyDB、Cloud SQL を活用したデータ基盤の構築・移行・運用にご関心がありましたら、お気軽にご相談ください。
お問い合わせはこちら
- XIMIX について: https://ximix.niandc.co.jp/about-ximix
参考資料
- Google Cloud Release Notes: https://cloud.google.com/release-notes
執筆者紹介