はじめに
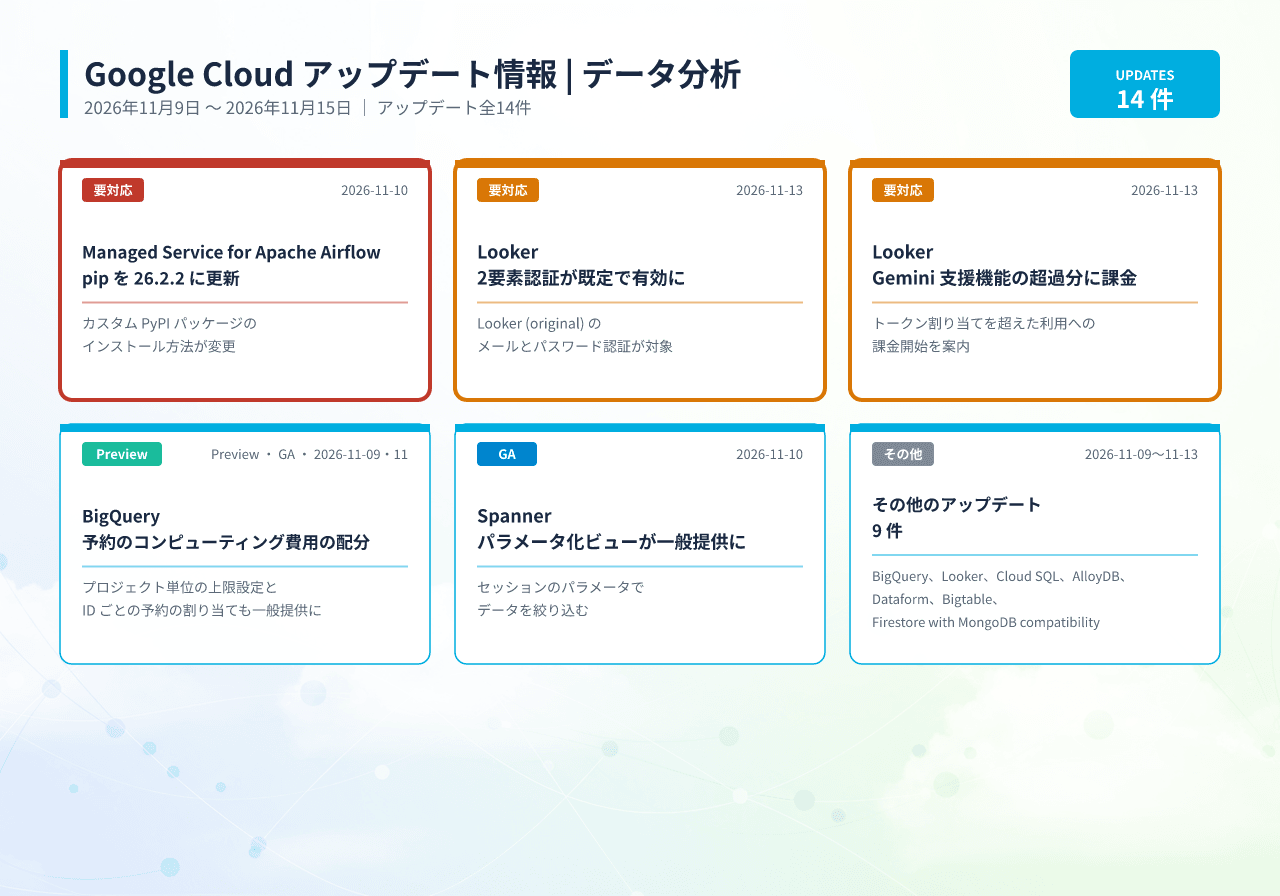
2026年11月9日〜11月15日の Google Cloud データ分析カテゴリでは、Looker の Looker (original) で2要素認証(2FA)が既定で有効になり、Gemini 支援機能のトークン割り当てを超えた利用への課金開始も案内されました。BigQuery では、予約の容量を使ったコンピューティング費用をクエリを実行したプロジェクトに配分する機能が Preview として公開され、プロジェクト単位の上限設定などの予約管理の機能が一般提供(GA)になっています。
本記事では、この期間に公開されたデータ分析カテゴリの更新のうち、主要な14件を取り上げます。既存の環境に影響する3件は「要対応のアップデート」に、残りの11件は日付順に「その他のアップデート詳細」にまとめ、細かな更新は末尾の「その他のアップデート」で紹介します。
IT 部門の方は、まず「要対応のアップデート」で自社の環境が該当するかをご確認ください。各トピックには、何が変わったのか、どんな業務シーンで使えるのかを整理し、公式ドキュメントへのリンクを添えています。
| 対象期間 | 2026年11月9日〜2026年11月15日 |
| 対象製品 | Google Cloud |
| 対象カテゴリ | データ分析 |
| アップデート件数 | 14件(主要トピック) |
今回のアップデート一覧
⚠️ 要対応のアップデート
1. Managed Service for Apache Airflow — pip を 26.2.2 に更新、カスタム PyPI パッケージのインストール方法が変更(2026年11月10日)
Managed Service for Apache Airflow(Google Cloud のマネージド Apache Airflow)で、Airflow 3.3.1、3.2.2、2.11.1 の pip パッケージがバージョン 23.2.1 から 26.2.2 に更新されました。この版にはセキュリティ修正が含まれ、カスタム PyPI パッケージのインストール方法が変わります。
✨ 使えるようになる機能
新しい機能の追加はありません。
⚠️ 使えなくなる機能 / 変更点
更新後の pip は、次のビルドとイメージ以降で使われます。
- Managed Airflow (Gen 3): composer-3-airflow-3.3.1-build.8、composer-3-airflow-3.2.2-build.12、composer-3-airflow-2.11.1-build.25
- Managed Airflow (Gen 2): composer-2.18.0-airflow-2.11.1
カスタム PyPI パッケージのインストールでは、次の点が変わります。
- PEP 440 のバージョン指定子: pip 26.2.2 は PEP 440 への準拠を求め、ワイルドカードの .* は == と != でのみ使えます。たとえば gcsfs>=0.8.* ではなく gcsfs>=0.8 と書きます
- 分離環境でのソースビルド: ソースパッケージ(.tar.gz)は常に分離された環境でビルドされます。プライベート リポジトリを唯一のパッケージ インデックスとしてソースパッケージをインストールしている場合は、そのリポジトリに setuptools などのビルド依存関係(pyproject.toml の [build-system] requires に記載されたもの)のビルド済み wheel パッケージ(.whl)を置くか、パッケージを .whl として公開します。一時的な回避策として、pip.conf の [global] セクションに no-build-isolation = false を追加するとビルドの分離を無効にできます。この回避策は、ビルド依存関係が環境にインストール済みの場合にだけ機能します
- pkg_resources を使う古いビルド: pkg_resources に依存する古いソースパッケージは、ビルドに失敗する場合があります。ビルド済みの .whl がある新しいバージョンを使うか、自社のプライベート パッケージは .whl としてビルドするか、ビルド スクリプトを pkg_resources を使わない形に更新します
アップグレード中に PyPI パッケージのインストールが失敗した場合、環境は現在のバージョンとパッケージのまま動作し続けます。
🤔 判断観点
- 影響範囲: 環境にカスタム PyPI パッケージを追加しているか。追加している場合、バージョン指定に >=0.8.* のような、== と != 以外でのワイルドカードを使っていないか
- 確認事項: プライベート リポジトリだけをパッケージ インデックスにしてソースパッケージ(.tar.gz)を入れている場合、ビルド依存関係の .whl がリポジトリにそろっているか
- 検証推奨事項: pkg_resources に依存する古いソースパッケージを使っていないか
- ロールアウト戦略: 公式ドキュメントでは、環境をアップグレードする前に、カスタム PyPI パッケージがこれらの変更に対応しているかを確認するよう案内しています
💼 確認が必要な場面(ユースケース)
Managed Service for Apache Airflow の環境にカスタム PyPI パッケージを追加してワークフローを運用し、上記のビルドやイメージへのアップグレードを予定している担当者が対象です。
📚 公式ソース
2. Looker — Looker (original) で2要素認証(2FA)が既定で有効に(2026年11月13日)
Looker(Google Cloud の BI・データ可視化プラットフォーム)で、メールアドレスとパスワードによる認証を使う Looker (original) インスタンスの2要素認証(2FA)が、既定で有効になりました。
✨ 使えるようになる機能
新しい機能の追加はありません。
⚠️ 使えなくなる機能 / 変更点
- 対象は、メールアドレスとパスワードによる認証を使い、事前のオプトアウト期間にオプトアウトしなかった、新規と既存のすべての Looker (original) インスタンスです
- 管理者は、Admin > Authentication > Two-Factor パネルで2FA を管理したり、無効にしたりできます
🤔 判断観点
- 影響範囲: 自社の Looker (original) インスタンスでメールアドレスとパスワードによる認証を使っているか。事前のオプトアウト期間にオプトアウトしたか
- 設定の確認: Two-Factor パネルで、2FA の現在の設定が自社の方針と合っているか
💼 確認が必要な場面(ユースケース)
メールアドレスとパスワードによる認証で Looker (original) を運用している Looker の管理者が対象です。
📚 公式ソース
- 製品ドキュメント: Admin settings - Two-factor authentication(Looker)
- リリースノート: Google Cloud release notes - November 13, 2026
3. Looker — Gemini 支援機能のトークン割り当てを超えた利用への課金開始を案内(2026年11月13日)
Looker で、Gemini 支援機能の利用のうち、インスタンスのトークン割り当てを超えた分の課金を開始すると案内されました。Gemini 支援機能は、会話型分析(Conversational Analytics)や、Gemini を使うその他の一般提供の機能を含むエージェント型の機能群です。
✨ 使えるようになる機能
新しい機能の追加はありません。
⚠️ 使えなくなる機能 / 変更点
- Gemini 支援機能の利用が、インスタンスのトークン割り当てを超えた場合、その超過分が課金の対象になります
- Looker の管理者は、有効な請求先アカウントを持つ Google Cloud プロジェクトを Looker インスタンスに関連付けて、この課金に備えられます。プロジェクトは、インスタンスの Gemini in Looker の管理ページで指定します
🤔 判断観点
- 影響範囲: 自社の Looker インスタンスで、会話型分析など Gemini 支援機能を使っているか
- 準備状況: Gemini in Looker の管理ページで、有効な請求先アカウントを持つ Google Cloud プロジェクトを指定しているか
💼 確認が必要な場面(ユースケース)
Looker で会話型分析などの Gemini 支援機能を使っている Looker インスタンスの管理者が対象です。
📚 公式ソース
- 製品ドキュメント: Gemini in Lookeradmin
- 製品ドキュメント: Manage billing for Gemini-assisted features in Looker
- リリースノート: Google Cloud release notes - November 13, 2026
その他のアップデート詳細
4. AlloyDB — AI 関数のスマート バッチ処理と、感情分析の ai.analyze_sentiment 関数が一般提供に(GA・2026年11月9日)
AlloyDB for PostgreSQL(Google Cloud の PostgreSQL 互換データベース)で、SQL から呼び出す AI 関数の処理を速くするスマート バッチ処理と、テキストの感情を分類する関数が一般提供(GA)になりました。
🔍 何が変わったのか
- スマート バッチ処理: PostgreSQL 17 以降の AlloyDB クラスタで、ai.if、ai.rank、ai.analyze_sentiment、ai.summarize、ai.extract、ai.classify、ai.generate の AI 関数を高速化します。対象の AI 処理を自動でまとめ、非同期の評価に回すため、クエリを複雑な配列の構造に書き換えなくても実行速度が上がります。PostgreSQL 18 以降では既定で有効です
- ai.analyze_sentiment 関数: PostgreSQL 17 以降の AlloyDB クラスタで使える組み込み関数です。SQL クエリの中で、テキストの感情を肯定・否定・中立にリアルタイムで分類します
💼 こんな場面で活用できます(ユースケース)
AlloyDB に蓄積したテキストを SQL で分析するデータ分析の担当者が、ai.analyze_sentiment でテキストを肯定・否定・中立に分類する場面で使えます。AI 関数を含むクエリを運用している開発者は、クエリを書き換えずに実行速度を上げられます。
✨ 導入メリット
- AI 関数を含むクエリを、配列の構造に書き換える手間をかけずに高速化できます
- テキストの感情の分類を、SQL クエリの中で直接実行できます
📚 公式ソース
- 製品ドキュメント: Accelerate performance for queries with AI functions(AlloyDB)
- 製品ドキュメント: Analyze text sentiment(AlloyDB)
- リリースノート: Google Cloud release notes - November 9, 2026
5. BigQuery — 予約のコンピューティング費用の配分が Preview に、プロジェクト単位の上限設定と ID ごとの予約の割り当ても一般提供に(Preview・GA・2026年11月9日・11日)
BigQuery(データを管理・分析する Google Cloud のデータ プラットフォーム)で、予約(reservation)の容量の費用配分と、予約を使うプロジェクトやユーザーの管理に関する機能が追加されました。
🔍 何が変わったのか
- コンピューティング費用の配分(11月9日・Preview): BigQuery editions でオプトインすると、管理プロジェクトの予約の容量を使ったクエリ プロジェクトに、請求されたコンピューティング費用を直接配分します。コミットメントと自動スケーリングのスロットの実際の使用量にもとづいて配分するため、プロジェクト単位の費用の把握や社内での費用の付け替え(チャージバック)に使えます
- ジョブ エクスプローラでのパフォーマンス分析(11月9日・GA): BigQuery のジョブ エクスプローラで、クエリ パフォーマンスのトラブルシューティングと、ジョブやシステムのパフォーマンスの比較ができます
- プロジェクトの上限(スケジューリング ポリシー)(11月11日・GA): BigQuery の予約の中で、プロジェクトごとの最大スロット数と同時実行数を制限できます
- 予約の割り当てでのプリンシパルの指定(11月11日・GA): 予約の割り当てに任意のプリンシパルのプロパティを指定し、ジョブを実行するユーザー、サービス アカウント、サードパーティの ID にもとづいて、クエリを特定の予約に振り分けられます
- プロジェクトの上限とプリンシパルの指定は、BigQuery の Enterprise と Enterprise Plus の各エディションでのみ使えます
💼 こんな場面で活用できます(ユースケース)
管理プロジェクトの予約を複数のプロジェクトで共有している場合に、FinOps の取り組みとしてプロジェクトごとの費用を把握し、社内のチャージバックに使う場面で使えます。予約の管理者は、特定のプロジェクトが使うスロット数と同時実行数を制限したり、サービス アカウントごとに使う予約を分けたりできます。
✨ 導入メリット
- 予約の費用を、実際のスロットの使用量にもとづいてクエリ プロジェクトごとに把握できます
- 1つの予約の中で、プロジェクトごとにスロット数と同時実行数の上限を設けられます
- ジョブを実行する ID に応じて、クエリを使わせたい予約に振り分けられます
📚 公式ソース
- 製品ドキュメント: Monitor BigQuery reservations - Attribute compute costs to individual projects(BigQuery)
- 製品ドキュメント: Monitor jobs - Troubleshoot job performance(BigQuery)
- 製品ドキュメント: Monitor jobs - Diagnose performance regressions by comparing jobs and systems(BigQuery)
- 製品ドキュメント: Understand reservations - Project caps and scheduling policies(BigQuery)
- 製品ドキュメント: Manage workload assignments(BigQuery)
- 製品ドキュメント: Understand BigQuery editions(BigQuery)
- リリースノート: Google Cloud release notes - November 9, 2026
- リリースノート: Google Cloud release notes - November 11, 2026
6. BigQuery — グラフのメジャーと JSON_FLATTEN 関数が一般提供に、Zstd 圧縮関数と MySQL・Oracle・PostgreSQL への連携クエリが Preview に(GA・Preview・2026年11月9日〜13日)
BigQuery の GoogleSQL で、集計、JSON、圧縮に関する関数が追加され、MySQL、Oracle、PostgreSQL のデータベースに対する連携クエリも Preview として使えるようになりました。
🔍 何が変わったのか
- 圧縮関数(11月9日・Preview): Zstandard(Zstd)の可逆圧縮アルゴリズムで、bytes や string の値を圧縮・展開します。対応する関数は ZSTD_COMPRESS、ZSTD_DECOMPRESS_TO_BYTES、ZSTD_DECOMPRESS_TO_STRING です
- グラフのメジャー(11月10日・GA): 集計をキーに固定し、重複して数えることなく複雑な集計を行えます。メジャーの式には、集計関数の呼び出し、集計関数の中の式や条件ロジック、条件付きの重複を除いたカウント、集計関数の外のスカラー演算、AGG 関数で囲んだメジャーの組み合わせを含められます
- メジャーをクエリするときは、GRAPH_EXPAND テーブル値関数でグラフをフラットなテーブルに変換し、そのテーブルに対して AGG 関数を使います。GRAPH_EXPAND は複数のファクト テーブルに対応し、出力のスキーマは BQ.SHOW_GRAPH_EXPAND_SCHEMA システム プロシージャで確認できます
- グラフのラベルとプロパティの OPTIONS 句には、自然言語でのクエリに使うカスタムのメタデータ(文字列のペア)を拡張として定義できます。メジャーとグラフは、BigQuery コネクタを通じて Data Studio で使え、Knowledge Catalog に自動で登録されて自然言語やドメインの同義語で検索できます
- JSON_FLATTEN 関数(11月11日・GA): 入力の JSON 値に直接含まれる値、または1つ以上の連続してネストした配列の子である値のうち、配列以外の値をすべて取り出します
- MySQL・Oracle・PostgreSQL への接続(11月13日・Preview): BigQuery から MySQL、Oracle、PostgreSQL への接続を作成し、それぞれに対する連携クエリ(federated query)を実行できます
💼 こんな場面で活用できます(ユースケース)
BigQuery Graph で集計を行うデータ分析の担当者が、メジャーを使って重複して数えずに集計し、結果を Data Studio のレポートで使う場面で活用できます。BigQuery から MySQL、Oracle、PostgreSQL のデータベースへ連携クエリを実行する場面でも使えます。
✨ 導入メリット
- 複数のファクト テーブルにまたがる集計でも、重複して数えることを避けられます
- ネストした配列を含む JSON から、配列以外の値を1つの関数でまとめて取り出せます
- MySQL、Oracle、PostgreSQL のデータを、BigQuery の連携クエリで参照できます
📚 公式ソース
- 製品ドキュメント: Compression functions(BigQuery)
- 製品ドキュメント: Work with measures(BigQuery)
- 製品ドキュメント: Data types - Measure type(BigQuery)
- 製品ドキュメント: Graphs within SQL - GRAPH_EXPAND(BigQuery)
- 製品ドキュメント: Aggregate functions - AGG(BigQuery)
- 製品ドキュメント: System procedures reference - BQ.SHOW_GRAPH_EXPAND_SCHEMA(BigQuery)
- 製品ドキュメント: Schema overview - Specify options(BigQuery)
- 製品ドキュメント: Connect to Google BigQuery(Data Studio)
- 製品ドキュメント: JSON functions - JSON_FLATTEN(BigQuery)
- 製品ドキュメント: Connect to MySQL(BigQuery)
- 製品ドキュメント: Connect to Oracle(BigQuery)
- 製品ドキュメント: Connect to PostgreSQL(BigQuery)
- 製品ドキュメント: Run MySQL federated queries(BigQuery)
- 製品ドキュメント: Run Oracle federated queries(BigQuery)
- 製品ドキュメント: Run PostgreSQL federated queries(BigQuery)
- リリースノート: Google Cloud release notes - November 9, 2026
- リリースノート: Google Cloud release notes - November 10, 2026
- リリースノート: Google Cloud release notes - November 11, 2026
- リリースノート: Google Cloud release notes - November 13, 2026
7. Dataform — 同時実行数の上限設定と、Knowledge Catalog でのテーブル単位のデータリネージの追跡が一般提供に(GA・2026年11月9日・12日)
Dataform(BigQuery 向けの SQL データ変換・ELT サービス)と BigQuery のパイプラインで、同時に実行する処理の数の上限を設定できるようになりました。どちらも、Knowledge Catalog(旧 Dataplex Universal Catalog。データ資産のメタデータを管理するカタログ)でテーブル単位のデータリネージを追跡できます。
🔍 何が変わったのか
- BigQuery パイプラインの同時実行数(11月9日・GA): パイプラインを作成またはスケジュールするときに、同時に実行するパイプラインのタスクの最大数を指定できます
- Dataform の同時実行数(11月9日・GA): 1回のワークフローの実行、またはワークフロー構成のスケジュールの中で、同時に実行するアクションの数を制限できます
- データリネージの追跡(11月12日・GA): Dataform のワークフローと BigQuery のパイプラインについて、テーブル単位のデータリネージを Knowledge Catalog で追跡できます
💼 こんな場面で活用できます(ユースケース)
Dataform や BigQuery のパイプラインでデータ変換を運用している担当者が、同時に実行するタスクやアクションの数を絞る場面で使えます。また、Dataform のワークフローや BigQuery のパイプラインのテーブル単位のリネージを Knowledge Catalog で確認できます。
✨ 導入メリット
- ワークフローやパイプラインの中で同時に動く処理の数を、実行時やスケジュールの設定で制御できます
- Dataform と BigQuery のパイプラインのテーブル単位のリネージを、Knowledge Catalog で追跡できます
📚 公式ソース
- 製品ドキュメント: Create pipelines(BigQuery)
- 製品ドキュメント: Schedule pipelines(BigQuery)
- 製品ドキュメント: Manually trigger runs - Limit concurrent actions(Dataform)
- 製品ドキュメント: Schedule runs - Create a workflow configuration(Dataform)
- 製品ドキュメント: Manage pipelines - Track data lineage(BigQuery)
- 製品ドキュメント: Track data lineage in Knowledge Catalog(Dataform)
- リリースノート: Google Cloud release notes - November 9, 2026
- リリースノート: Google Cloud release notes - November 12, 2026
8. Bigtable — Avro スキーマ バンドルのコンソール管理が Preview に、アクセス パターンの分析が一般提供に(Preview・GA・2026年11月9日・13日)
Bigtable(大量のデータを低レイテンシで扱う Google Cloud のデータベース)で、Google Cloud コンソールからスキーマの管理と、読み書きの傾向の分析ができるようになりました。
🔍 何が変わったのか
- Avro スキーマ バンドル(11月9日・Preview): Google Cloud コンソールで、Bigtable のテーブル用の Apache Avro スキーマ バンドルを作成・管理できます。Bigtable Studio では、Avro スキーマ バンドルの定義を表示できます
- アクセス パターンの分析(11月13日・GA): Google Cloud コンソールで、インスタンスとクラスタの読み取りと書き込みのアクセス パターンを表示・分析できます。リクエスト量、レイテンシ、帯域幅、行スキャンの指標を、クエリの種類ごとに確認できます
💼 こんな場面で活用できます(ユースケース)
Bigtable のテーブルで Apache Avro のスキーマを使っている開発者が、スキーマ バンドルをコンソールで作成・管理する場面で使えます。Bigtable を運用する担当者は、クエリの種類ごとのリクエスト量やレイテンシをコンソールで確認できます。
✨ 導入メリット
- Avro スキーマ バンドルの作成と定義の確認を、コンソールと Bigtable Studio で行えます
- 読み書きのアクセス パターンを、クエリの種類ごとの指標で把握できます
📚 公式ソース
- 製品ドキュメント: Create and manage Avro schemas(Bigtable)
- 製品ドキュメント: Analyze access patterns(Bigtable)
- リリースノート: Google Cloud release notes - November 9, 2026
- リリースノート: Google Cloud release notes - November 13, 2026
9. Cloud SQL — Enterprise Plus で C4D マシンシリーズが東京などで利用可能に、SQL Server の Knowledge Catalog 連携が新規インスタンスで既定有効に(2026年11月9日)
Cloud SQL(Google Cloud のマネージド リレーショナル データベース)の MySQL、PostgreSQL、SQL Server の Enterprise Plus インスタンスで、C4D マシンシリーズが使えるようになりました。Cloud SQL for SQL Server では、新規インスタンスと Knowledge Catalog の連携が既定で有効になっています。
🔍 何が変わったのか
- C4D マシンシリーズ: Cloud SQL for MySQL、Cloud SQL for PostgreSQL、Cloud SQL for SQL Server の Enterprise Plus インスタンスで、次のリージョンで使えます
- africa-south1(ヨハネスブルグ)、asia-northeast1(東京)、europe-west1(ベルギー)、europe-west2(ロンドン)、europe-west3(フランクフルト)、europe-west4(オランダ)、europe-west9(パリ)、us-east1(サウスカロライナ)、us-east4(北バージニア)
- C4D は、第5世代の AMD EPYC プロセッサ(Turin)と Google Titanium で動作し、IOPS とスループットを調整できる Hyperdisk Balanced のストレージを使います
- Knowledge Catalog との連携(Cloud SQL for SQL Server): 2026年11月9日以降に新規作成したインスタンスは、メタデータとスキーマの更新をほぼリアルタイムで Knowledge Catalog に送ります。新規インスタンスでは連携が既定で有効で、いつでも確認や設定の変更ができます
💼 こんな場面で活用できます(ユースケース)
負荷の高いワークロードを Cloud SQL の Enterprise Plus で運用しているデータベース管理者が、東京リージョンで C4D マシンシリーズを選ぶ場面で使えます。Knowledge Catalog でデータ資産を管理している部門は、新しく作成した Cloud SQL for SQL Server のスキーマの変更を、ほぼリアルタイムでカタログに反映できます。
✨ 導入メリット
- 公式ドキュメントでは、C4D は負荷の高いワークロードに安定した高い性能を提供すると説明されています
- ストレージの IOPS とスループットを、ワークロードに合わせて調整できます
- 新規の SQL Server インスタンスのメタデータを、追加の設定なしで Knowledge Catalog に反映できます
📚 公式ソース
- 製品ドキュメント: Choose a machine series - C4D machine series(Cloud SQL for MySQL)
- 製品ドキュメント: Choose a machine series - C4D machine series(Cloud SQL for PostgreSQL)
- 製品ドキュメント: Choose a machine series - C4D machine series(Cloud SQL for SQL Server)
- 製品ドキュメント: Manage your Cloud SQL resources using Knowledge Catalog(Cloud SQL for SQL Server)
- リリースノート: Google Cloud release notes - November 9, 2026
10. Firestore with MongoDB compatibility — 自然言語で業務データをクエリできる会話型分析が Preview に(Preview・2026年11月9日)
Firestore with MongoDB compatibility で、業務データを自然言語でクエリできる会話型分析が Preview として公開されました。この機能は Conversational Analytics API を使っています。
🔍 何が変わったのか
- Firestore with MongoDB compatibility の業務データ(オペレーショナル データ)に、自然言語でクエリできます
- 機能の基盤は Conversational Analytics API です
💼 こんな場面で活用できます(ユースケース)
Firestore with MongoDB compatibility に保存された業務データを確認したい担当者が、自然言語で質問する場面で使えます。
✨ 導入メリット
- 業務データへのクエリを、自然言語で行えます
📚 公式ソース
- 製品ドキュメント: Conversational analytics for Firestore with MongoDB compatibility
- 製品ドキュメント: Build data agents and chat with your data(Conversational Analytics API)
- リリースノート: Google Cloud release notes - November 9, 2026
11. Spanner — セッションのパラメータでデータを絞り込むパラメータ化ビューが一般提供に(GA・2026年11月10日)
Spanner(Google Cloud のグローバル分散データベース)で、パラメータ化ビューが一般提供(GA)になりました。
🔍 何が変わったのか
- パラメータ化ビューは、クエリとともに渡されるセッション コンテキストのパラメータにもとづいて、データを動的に絞り込みます
- AI エージェントや LLM のアプリケーションで、テナントごとのデータの分離やデータへのアクセスの制限に使えます
💼 こんな場面で活用できます(ユースケース)
複数のテナントのデータを扱う AI エージェントや LLM のアプリケーションを開発する開発者が、テナントごとにデータを分けて見せる場面で使えます。
✨ 導入メリット
- クエリに渡すセッションのパラメータで、ビューが返すデータを動的に絞り込めます
- AI エージェントや LLM のアプリケーションがアクセスできるデータを、ビューの段階で制限できます
📚 公式ソース
- 製品ドキュメント: Parameterized views overview(Spanner)
- 製品ドキュメント: Create and manage views - Create a parameterized view(Spanner)
- 製品ドキュメント: Use parameterized views(Spanner)
- リリースノート: Google Cloud release notes - November 10, 2026
12. Cloud SQL — 拡張バックアップが災害復旧(DR)レプリカを持つインスタンスに対応(2026年11月13日)
Cloud SQL for MySQL、Cloud SQL for PostgreSQL、Cloud SQL for SQL Server の拡張バックアップ(enhanced backups)が、災害復旧(DR)レプリカ インスタンスを持つインスタンスに対応しました。
🔍 何が変わったのか
- DR レプリカを指定したプライマリ インスタンスに、Backup and DR のバックアップ プランを直接関連付けられます
💼 こんな場面で活用できます(ユースケース)
DR レプリカを用意して Cloud SQL を運用しているデータベース管理者が、そのプライマリ インスタンスのバックアップを Backup and DR のバックアップ プランで管理する場面で使えます。
✨ 導入メリット
- DR レプリカを持つ構成でも、拡張バックアップを選べるようになります
📚 公式ソース
- 製品ドキュメント: Choose your backup option(Cloud SQL for MySQL)
- 製品ドキュメント: Manage enhanced backups(Cloud SQL for MySQL)
- 製品ドキュメント: Choose your backup option(Cloud SQL for PostgreSQL)
- 製品ドキュメント: Manage enhanced backups(Cloud SQL for PostgreSQL)
- 製品ドキュメント: Choose your backup option(Cloud SQL for SQL Server)
- 製品ドキュメント: Manage enhanced backups(Cloud SQL for SQL Server)
- リリースノート: Google Cloud release notes - November 13, 2026
13. Looker — Google グループのミラーリングに対応、公式の BigQuery JDBC ドライバも Preview で選択可能に(Preview・2026年11月13日)
Looker で、Google 認証とデータベース接続の管理に関する機能が追加されました。この項目は Looker の管理者向けの更新です。2FA の既定有効化は「2. Looker」で紹介しています。
🔍 何が変わったのか
- Google グループのミラーリング: Looker (original) で、Google グループのメンバーシップにもとづいて Looker のロールとグループを自動で割り当てられます。更新された Google 認証の管理ページには、高度なロール管理と、Looker API による設定の機能も加わりました
- 公式の BigQuery JDBC ドライバ(Preview): Looker の管理者は、BigQuery の接続で、Google が開発・サポートする公式の BigQuery JDBC ドライバにオプトインできます。このドライバは、将来のリリースで現在の Looker のレガシー ドライバに置き換わる予定です
- ドライバを試すには、Admin > Database > Connections で BigQuery の接続を編集し、Use latest stable driver をオフにしてから、Driver Version で BigQuery Official [Preview] のいずれかを選びます。Test で接続を確認してから Update Connection を選択します
- 既存の接続は、管理者がオプトインしない限り現在のドライバを使い続けます。以前のドライバのバージョンを選べば、いつでも元に戻せます
💼 こんな場面で活用できます(ユースケース)
Looker の管理者が、Google グループのメンバーシップをもとに Looker のロールとグループを割り当てる場面で使えます。BigQuery に接続して Looker を運用している管理者は、公式の JDBC ドライバを特定の接続で試し、問題があれば以前のドライバに戻せます。
✨ 導入メリット
- Looker のロールとグループの割り当てを、Google グループのメンバーシップに合わせて自動化できます
- Google 認証の設定を、Looker API から行えます
- レガシー ドライバの置き換えの前に、公式の BigQuery JDBC ドライバを接続単位で検証できます
📚 公式ソース
- 製品ドキュメント: Admin settings - Google authentication - Mirror Google Groups(Looker)
- 製品ドキュメント: Admin settings - Google authentication - Advanced role management(Looker)
- 製品ドキュメント: Configuring Google authentication using the API(Looker)
- 製品ドキュメント: Google BigQuery - Official BigQuery JDBC driver(Looker)
- 製品ドキュメント: Admin settings - Connections - Editing connections(Looker)
- 製品ドキュメント: Connecting Looker to your database - Driver version(Looker)
- リリースノート: Google Cloud release notes - November 13, 2026
14. Looker — サンキー チャートが一般提供に、上位以外の行を「Other」にまとめる表示とダウンロード時のフィルタ情報の付加にも対応(GA・2026年11月13日)
Looker で、可視化とダウンロードに関する機能が追加・変更されました。
🔍 何が変わったのか
- サンキー チャート(GA): カテゴリ、段階、状態のあいだのデータの流れと分布を可視化します。カスタマー ジャーニー、Web サイトの遷移、システム間のリソース配分のような、複数の段階を経る経路の分析に向いています
- 「Other」カテゴリへのグループ化: Limit Displayed Rows または Limit Displayed Pivot Columns を使うとき、Group remaining rows into 'Other' または Group remaining pivots into 'Other' を選ぶと、上位 N 件の行やピボット列と、残りを集計した「Other」カテゴリを並べて表示できます。カテゴリのラベルは変更でき、一部のグラフの種類では色も指定できます。行のグループ化は表、棒、縦棒、折れ線、面、散布図、円、ドーナツ マルチプルに、ピボットのグループ化は表、棒、縦棒、折れ線、面、散布図に対応します
- ダウンロード時のフィルタとクエリの情報: Look、Explore、ダッシュボードのタイルのダウンロードで、フィルタとクエリの情報をファイルに含められます。PNG 画像にはフィルタのバナーを、Excel のワークブックにはクエリのメタデータとフィルタのシートを含められます。ダッシュボードの編集者は、タイルのダウンロードでの Excel のメタデータの既定の設定をダッシュボードの設定で決められます。タブ付きのダッシュボードを PDF でダウンロードするときは、すべてのフィルタを PDF の先頭に表示するか、各タブで有効なフィルタをタブの見出しの下に表示するかを選べます
- PDF の設定の変更: ダッシュボードを PDF でダウンロードするとき、または PDF でのダッシュボードの配信を設定するときに Expand tables to show all rows を選ぶと、Fit Page to Dashboard は選べなくなり、用紙サイズは A4 に、改ページは既定で有効になります
💼 こんな場面で活用できます(ユースケース)
Web サイトでの利用者の遷移やカスタマー ジャーニーを分析する担当者が、サンキー チャートで段階ごとの流れを可視化する場面で使えます。ダッシュボードのデータを Excel や PNG で社内に共有する担当者は、どのフィルタで抽出したデータかをファイルに残せます。
✨ 導入メリット
- 複数の段階を経るデータの流れを、1つのグラフで確認できます
- 行やピボット列の数を絞っても、残りの分を「Other」として集計して表示できます
- ダウンロードしたファイルに、抽出条件のフィルタとクエリの情報を含められます
📚 公式ソース
- 製品ドキュメント: Table chart options - Limit Displayed Rows(Looker)
- 製品ドキュメント: Table chart options - Limit Displayed Pivot Columns(Looker)
- 製品ドキュメント: Downloading content - Filter and query metadata(Looker)
- 製品ドキュメント: Editing user-defined dashboards - Add query metadata sheet(Looker)
- 製品ドキュメント: Adding tabs to dashboards(Looker)
- 製品ドキュメント: Downloading content - Downloading a dashboard as a PDF(Looker)
- 製品ドキュメント: Scheduling and sending dashboards - Expand tables to show all rows(Looker)
- リリースノート: Google Cloud release notes - November 13, 2026
その他のアップデート
上記のほかに、今回の期間には次のアップデートが公開されました。
- Memorystore for Redis(2026年11月9日): CLIENT コマンドと、CACHING、GETNAME、GETREDIR、HELP、ID、INFO、KILL、LIST、NO-TOUCH、REPLY、SETNAME、TRACKING、TRACKINGINFO のサブコマンドに対応しました。GA です。(公式ドキュメント)
- BigQuery(2026年11月10日・12日): BigQuery の生成 AI 関数で、gemini-4-carbon モデル(11月10日)と gemini-4-hydrogen モデル(11月12日)を使えるようになりました。どちらのモデルも GA です。(公式ドキュメント)
まとめ
2026年11月9日〜11月15日のデータ分析カテゴリでは、Looker (original) で2FA が既定で有効になり、Looker の Gemini 支援機能ではトークン割り当てを超えた利用への課金開始が案内されました。Managed Service for Apache Airflow では pip が 26.2.2 に更新され、カスタム PyPI パッケージのインストール方法が変わっています。機能面では、BigQuery の予約のプロジェクト単位の上限設定やグラフのメジャー、Spanner のパラメータ化ビューが GA となり、BigQuery の予約のコンピューティング費用の配分や MySQL・Oracle・PostgreSQL への連携クエリが Preview で公開されました。IT 部門の方は要対応の3件で自社環境の該当有無を、クラウド費用を管理する部門の方は BigQuery の予約に関する更新を、それぞれ確認できます。
関連 XIMIX 記事
Google Cloud アップデート情報をシリーズでご覧になりたい方は、アップデート情報一覧から過去の記事もご確認いただけます。
XIMIX からのご案内
XIMIX(サイミクス)は NI+C が運営する Google Cloud プレミアパートナーサービスです。Google Cloud / Google Workspace の導入・活用支援、データ活用、AI 活用などをご支援しています。本記事で取り上げた BigQuery や Looker、Cloud SQL、Managed Service for Apache Airflow を活用したデータ基盤の構築・移行・運用にご関心がありましたら、お気軽にご相談ください。
お問い合わせはこちら
- XIMIX について: https://ximix.niandc.co.jp/about-ximix
参考資料
- Google Cloud Release Notes: https://cloud.google.com/release-notes
- 2026-11-09: Google Cloud release notes - November 9, 2026
- 2026-11-10: Google Cloud release notes - November 10, 2026
- 2026-11-11: Google Cloud release notes - November 11, 2026
- 2026-11-12: Google Cloud release notes - November 12, 2026
- 2026-11-13: Google Cloud release notes - November 13, 2026
執筆者紹介