はじめに
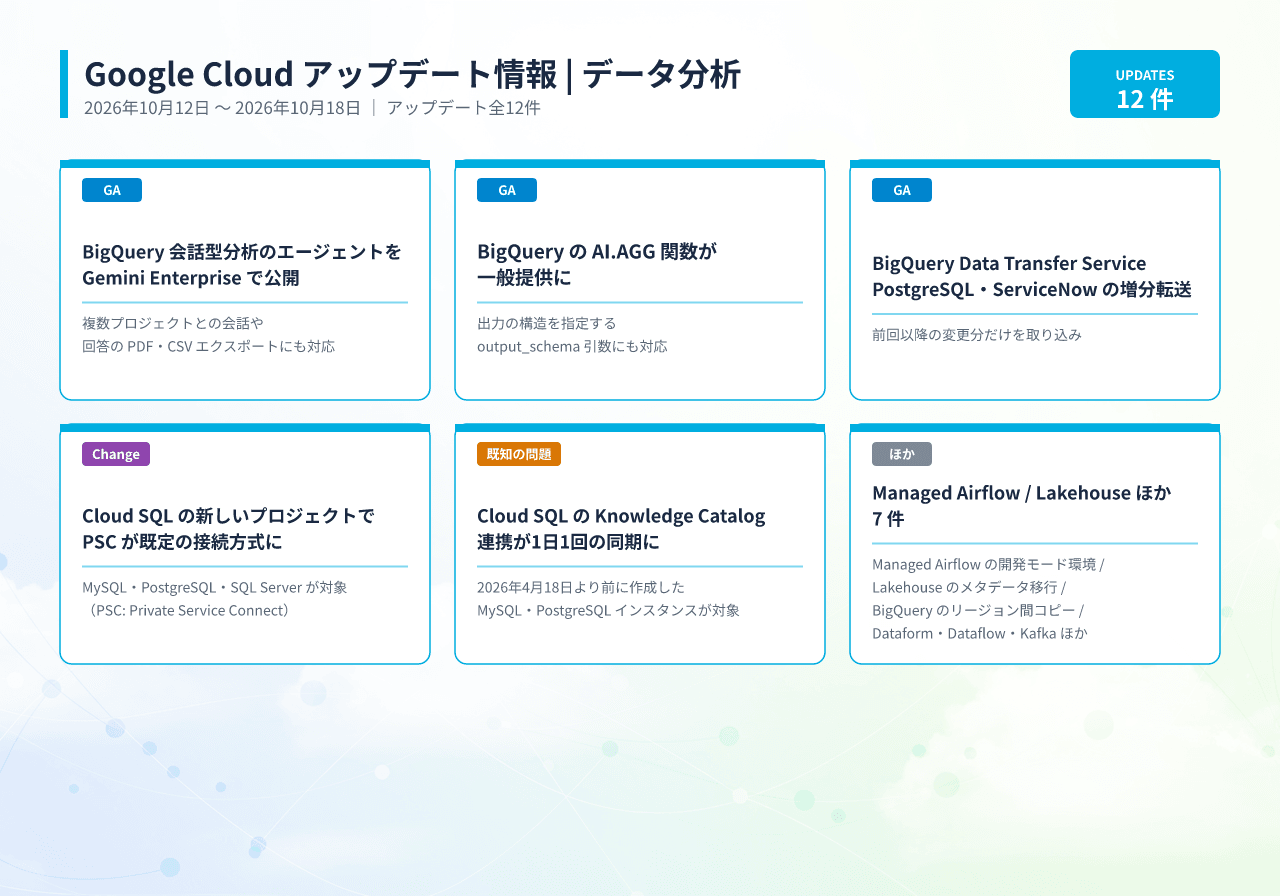
2026年10月12日〜10月18日の Google Cloud データ分析カテゴリでは、BigQuery の会話型分析で作成したエージェントを Gemini Enterprise に公開する機能が一般提供(GA)となり、自然な言葉の指示でデータを集約する AI.AGG 関数も GA になりました。Managed Service for Apache Airflow では、開発モード環境と環境の休止が GA となり、アップグレードのロールバックも使えるようになっています。
本記事では、この期間に公開されたデータ分析カテゴリの更新のうち、主要な12件を「アップデート詳細」で取り上げます。小規模な変更は「その他のアップデート」にまとめました。Cloud SQL の接続方式の既定値変更や、Managed Airflow のバージョン・ビルドのサポート終了など、既存の運用に関係する項目も含まれます。
各トピックでは「何が変わったのか」「どんな業務シーンで使えるのか」「どんなメリットがあるのか」を、業務担当者・IT 部門・経営層の方に向けて整理し、公式ドキュメントへのリンクを添えています。既定値の変更やサポート終了を含む項目には、自社で対応を判断するための観点もあわせて記載しました。
| 対象期間 | 2026年10月12日〜2026年10月18日 |
| 対象製品 | Google Cloud |
| 対象カテゴリ | データ分析 |
| アップデート件数 | 12件(主要トピック) |
今回のアップデート一覧
アップデート詳細
1. BigQuery Data Transfer Service — PostgreSQL と ServiceNow の増分転送が一般提供に(GA・2026年10月12日)
BigQuery Data Transfer Service(外部のデータを定期的に BigQuery へ取り込むサービス)で、PostgreSQL と ServiceNow からの増分転送が一般提供(GA)になりました。増分転送は、前回の転送以降に変更されたデータだけを取り込む方式です。毎回すべてのデータを取り込む全件転送と、転送設定で選べます。
🔍 何が変わったのか
- 増分転送を選ぶ場合は、書き込みモードとして Append(追記)か Upsert(更新または追加)を指定します
- Append は新しい行を追加するだけで、既存の行は確認しません。PostgreSQL のドキュメントでは、宛先のテーブルでデータが重複する可能性があると説明されています。ウォーターマーク列(変更を追跡する列)には、作成時に一度だけ設定される列(作成日時など)を選ぶことが推奨されています
- Upsert は主キーで行を照合し、一致すれば更新、なければ追加します。行の変更のたびに更新される列(更新日時など)をウォーターマーク列とし、値が一意で NULL を含まない主キーを指定します
- ServiceNow のドキュメントには、ウォーターマーク列に使えるのは DATETIME 型の列だけであること、元テーブルでの削除は同期されないこと、最初の増分転送の後は書き込みモード・ウォーターマーク列・主キーを変更できないことが制限として記載されています
💼 こんな場面で活用できます(ユースケース)
業務システムの PostgreSQL データベースや、ServiceNow のチケットなどのデータを、毎日 BigQuery に取り込んで分析しているデータエンジニアが使えます。更新日時の列を持つテーブルであれば、Upsert で変更された行だけを宛先のテーブルに反映できます。
✨ 導入メリット
- 前回以降の変更分だけを取り込むため、毎回全件を読み込む方式に比べて1回あたりの転送対象を減らせます
- 取り込みの仕組みを自前で作らずに、マネージドサービスの設定だけで差分の取り込みを構成できます
- 一般提供(GA)となり、本番のデータ連携に組み込む計画を立てられます
📚 公式ソース
- 製品ドキュメント: Introduction to PostgreSQL data transfers - Full or incremental transfers(BigQuery)
- 製品ドキュメント: Schedule a ServiceNow transfer - Full or incremental transfers(BigQuery)
- リリースノート: Google Cloud release notes - October 12, 2026
2. BigQuery — AI.AGG 関数が一般提供に、出力の構造を指定する output_schema 引数にも対応(GA・2026年10月13日・14日)
BigQuery の AI.AGG 関数が10月13日に一般提供(GA)となり、翌14日には出力の構造を指定できる output_schema 引数にも対応しました(こちらも GA)。AI.AGG は、自然な言葉による指示に基づいて、Gemini モデルで非構造化データを集約する関数です。GROUP BY と組み合わせると、グループごとに1つの結果を返します。
🔍 何が変わったのか
- テキストのほか、画像・音声・動画・PDF などのマルチモーダルな入力を集約できます。公式ドキュメントによると、データを分けて集約し、その結果をさらに集約する多段の処理を行うため、Gemini の標準のコンテキストウィンドウ(一度に扱える入力量)を超える入力も扱えます
- output_schema には、出力の項目をカンマ区切りで指定します。使える型は STRING、INT64、FLOAT64、BOOL、ARRAY、STRUCT で、指定すると結果は文字列ではなく STRUCT 型(複数の項目をまとめた型)で返ります
- 公式ドキュメントでは、グループ数を1,000以下にすることと、入力の種類ごとの行数の目安が推奨されており、これを超えるクエリは失敗するか、一部の結果だけを返す場合があります。出力はグループごとに10,000トークンが上限です
💼 こんな場面で活用できます(ユースケース)
公式ドキュメントでは、ユーザーレビューの感情分析、ログの分析、テストの失敗を共通の原因ごとにまとめるエラーの分類などが用途として挙げられています。たとえば、製品別に集めた問い合わせやレビューを、カスタマーサポートの担当者が「製品ごとの主な不満点」として要約する処理を SQL で書けます。output_schema を使えば、要約文と件数などを別々の項目として受け取れます。
✨ 導入メリット
- 大量の自由記述やファイルの要点を、SQL のクエリの中で集約できます
- output_schema で結果を決まった項目の形で受け取れるため、後続の集計やダッシュボードにそのまま使えます
- 一般提供(GA)となり、定期的な分析処理への組み込みを計画できます。なお、公式ドキュメントでは推論の処理が比較的高価であるとして、複雑なクエリでは対象のデータを先に別のテーブルへ書き出し、そのテーブルに対して推論を実行することが推奨されています
📚 公式ソース
- 製品ドキュメント: The AI.AGG function(BigQuery)
- リリースノート: Google Cloud release notes - October 13, 2026
- リリースノート: Google Cloud release notes - October 14, 2026
3. Cloud SQL for MySQL・PostgreSQL・SQL Server — 新しいプロジェクトでは Private Service Connect が既定の接続方式に(2026年10月13日)
Cloud SQL for MySQL、Cloud SQL for PostgreSQL、Cloud SQL for SQL Server の3つで、新しい Google Cloud プロジェクトにインスタンスを作成する場合、Private Service Connect(PSC)がプライベート IP 接続の既定の方式になりました。PSC は、VPC(Virtual Private Cloud。Google Cloud 上の仮想ネットワーク)を経由してインスタンスへ非公開で接続する仕組みの一つです。
🔍 何が変わったのか
- 新しいプロジェクトでインスタンスを作成すると、プライベート IP 接続の既定が PSC になります
- PSC では、異なるグループ・プロジェクト・組織にまたがる複数の VPC ネットワークからインスタンスに接続できます。エンドポイントと DNS レコードの自動作成にも対応しています
- プライベート IP を構成する際は、従来の private services access(プライベート サービス アクセス)を選ぶことも、両方の接続方式を併用することもできます
✨ 使えるようになる機能
- 新しいプロジェクトでは、PSC による複数 VPC からの接続や、エンドポイント・DNS レコードの自動作成を既定の構成で使えます
⚠️ 使えなくなる機能 / 変更点
- 既定値の変更: 新しいプロジェクトでインスタンスを作成するときの、プライベート IP 接続の既定が PSC に変わります。private services access を使う場合や両方を併用する場合は、構成時にその方式を選びます
- 本告知には、private services access の廃止・非推奨に関する記載はありません
💼 こんな場面で活用できます(ユースケース)
部門やグループ会社ごとにプロジェクトや VPC を分けている組織で、インフラ担当者が複数のネットワークから同じデータベースへ接続する構成を設計する場面で使えます。新しいプロジェクトでデータベースを立ち上げる際には、既定の接続方式を前提に設計を始められます。
✨ 導入メリット
- 複数の VPC ネットワークからの接続を、既定の構成で用意できます
- エンドポイントと DNS レコードを自動で作成できるため、接続の準備にかかる手作業を減らせます
🤔 判断観点
自組織の利用状況に照らして、以下の観点をご確認いただくとよいでしょう。XIMIX として一律の対応を推奨するものではなく、状況に応じたご判断の材料としてご参照ください。
- 影響範囲: 対象は新しいプロジェクトでのインスタンス作成です。今後新しいプロジェクトに Cloud SQL を作成する予定があるかを確認します
- 手順書・テンプレート: インスタンス作成の手順書や構成テンプレートが private services access を前提にしている場合、どちらの方式を使うかを明記するかを検討します
- 接続方式の選択: 複数の VPC から接続する必要があるか、既存のネットワーク構成とどちらの方式が合うかを、公式ドキュメントの構成オプションと照らして確認します
📚 公式ソース
- 製品ドキュメント: About Private Service Connect(Cloud SQL for MySQL)
- 製品ドキュメント: About Private Service Connect(Cloud SQL for PostgreSQL)
- 製品ドキュメント: About Private Service Connect(Cloud SQL for SQL Server)
- 製品ドキュメント: Private IP configuration options(Cloud SQL for MySQL)
- 製品ドキュメント: Configure Private Service Connect(Cloud SQL for MySQL)
- リリースノート: Google Cloud release notes - October 13, 2026
4. Dataform — Secure Source Manager との接続(Preview)と、ガバナンス設定を保持するオプション(GA)(2026年10月13日・14日)
Dataform(BigQuery 向けに SQL でデータ変換の処理を管理するサービス)で、2件の更新がありました。10月13日に、Developer Connect を使って Dataform のリポジトリを Secure Source Manager(Google Cloud のマネージド Git リポジトリ サービス)のリポジトリに接続できるようになりました(Preview)。10月14日には、テーブルに設定したデータポリシーなどを実行のたびに保持する preserveGovernanceControls オプションが一般提供(GA)になっています。
🔍 何が変わったのか
- Secure Source Manager との接続(Preview): Dataform のリポジトリ設定から Developer Connect を選び、Secure Source Manager のインスタンスとリポジトリを指定して接続します。接続のリージョンは Secure Source Manager のインスタンスと同じにする必要があり、Developer Connect のプロキシは有効のままにします
- preserveGovernanceControls(GA): Dataform がテーブルを作り直すと、列レベルのアクセス制御のメタデータは通常削除されます。このオプションを有効にすると、BigQuery のデータポリシーと、データ ガバナンス タグ(この部分は Preview)を保持したまま実行できます
- preserveGovernanceControls は、テーブルごとの設定か、プロジェクト全体の設定ファイル(workflow_settings.yaml)で有効にします。Dataform core 3.0.62 以降が必要です
- 公式ドキュメントでは、テーブルレベルのタグと行アクセス ポリシーは保持されないこと、ポリシータグには対応していないこと、列名を変更した場合はポリシーとタグを手動で再設定する必要があることが制限として挙げられています
💼 こんな場面で活用できます(ユースケース)
個人情報を含む列にデータポリシーを設定したテーブルを、Dataform で毎日作り直しているデータ基盤の担当者が使えます。実行のたびに列のデータポリシーを再設定する作業を減らせます。ソースコードの管理に Secure Source Manager を使っている組織では、Dataform の SQL も同じ環境で管理できます。
✨ 導入メリット
- テーブルの再作成後もデータポリシーとタグが保持され、データ ガバナンスを保ったままパイプラインを運用できます
- 保持の設定をプロジェクト全体でまとめて有効にできるため、テーブルごとに再設定の処理を書く手間を減らせます
- Secure Source Manager と接続でき、Dataform のコードを置くリポジトリの選択肢が広がります
📚 公式ソース
- 製品ドキュメント: Connect to a third-party Git repository - Developer Connect(Dataform)
- 製品ドキュメント: Create tables - Preserve access controls metadata(Dataform)
- リリースノート: Google Cloud release notes - October 13, 2026
- リリースノート: Google Cloud release notes - October 14, 2026
5. Managed Service for Apache Airflow — 開発モード環境と休止が一般提供に、アップグレードのロールバックも追加(GA・2026年10月13日・14日)
Managed Service for Apache Airflow(Managed Airflow。旧 Cloud Composer。ワークフロー管理ツール Apache Airflow のマネージドサービス)で、10月13日に新しいリリースの展開が始まりました。Managed Airflow (Gen 3) では、開発モード環境と環境の休止が一般提供(GA)となり、アップグレードのロールバックが追加されています。あわせて、複数のバージョン・ビルドのサポート終了と、GKE クラスタのメンテナンス除外期間が告知されました。
🔍 何が変わったのか
- 開発モード環境と休止(GA): Airflow 3 の Gen 3 環境を開発モードで作成し、本番に公開する前に DAG(Airflow で定義する処理の流れ)を試せます。使わないときは環境を休止でき、休止により環境のコストの大半がゼロになります
- アップグレードのロールバック: 性能の低下や Airflow の不具合、DAG・プラグイン・依存関係との互換性の問題が起きたときに、環境のアップグレードを元に戻せます。数回のリリースに分けて展開中で、今回は europe-north1、europe-west3、us-east1、us-west2 で利用できます
- データベースの保持設定: Gen 3 のデータベース保持の対象に Airflow 3 の新しいメタデータテーブルが加わり、ログに削除した行数が正確に記録されるようになりました。こちらも上記の4リージョンから順次展開されます
- 新しいビルドとイメージ: Gen 3 では composer-3-airflow-3.3.1-build.4、composer-3-airflow-3.2.2-build.8、composer-3-airflow-2.11.1-build.21(既定)が、Gen 2 では composer-2.17.15-airflow-2.11.1(既定)が使えるようになりました。apache-airflow-providers-cncf-kubernetes は 10.23.0 に、apache-airflow-providers-google は 22.6.0 に更新されています
- その他の変更: Gen 3 にスケジューラのループ1回の所要時間を示す指標(composer.googleapis.com/workload/scheduler/loop_duration)が追加されました。また、組織のポリシー Restrict Endpoint Usage が有効な状態で作成した Gen 3 環境は、Cloud Storage、Cloud Logging、Pub/Sub、Data Lineage などにリージョン エンドポイントを使うようになりました
- 不具合の修正: 環境の監視・運用関連で、Gen 2 の airflow-monitoring Pod がメモリ不足で停止する場合がある問題など、3件が修正されました
✨ 使えるようになる機能
- 開発モード環境: 標準の耐障害性と Small プリセットで動作し、コンポーネント数やリソースの上限は変更できません。既存の環境を開発モードに切り替えることはできず、公式ドキュメントでは本番環境に使わないよう注意されています
- 休止: 休止中は Airflow のコンポーネントが停止し、DAG の実行・解析も行われません。休止したコンポーネントの保存に DCU は引き続き消費されます。再開はコンソール、gcloud、API から行えます
- ロールバック: 環境が RUNNING 状態であれば、アップグレードから30日以内に元に戻せます。操作は gcloud CLI、API、Terraform で行い、コンソールには対応していません。DAG の定義や実行履歴、構成のオーバーライド、環境変数、追加した PyPI パッケージなどは保持されます
⚠️ 使えなくなる機能 / 変更点
- サポート終了: 次のバージョン・ビルドがサポート期間の終了を迎えました。composer-3-airflow-2.9.3-build.35、composer-3-airflow-2.10.5-build.15、composer-3-airflow-2.9.3-build.36、composer-3-airflow-2.10.5-build.16、composer-2.14.3-airflow-2.9.3、composer-2.14.3-airflow-2.10.5、composer-2.14.4-airflow-2.9.3、composer-2.14.4-airflow-2.10.5
- バージョン管理の公式ドキュメントによると、サポートが終了したビルドの環境も引き続き動作し、サポート対象のビルドへアップグレードできます。Gen 3 では、サポート終了後の環境は全面的に利用者の管理となります。脆弱性によっては、新しいバージョンへのアップグレードが唯一の対処になる場合があるとも記載されています
- メンテナンス除外期間: すべての Managed Airflow 環境の GKE クラスタに、2026年11月16日〜12月2日のメンテナンス除外が設定されます(10月14日の告知)
- 休止中の環境: 休止中の環境は更新もアップグレードもできません。ただし、メンテナンスの時間枠での自動アップグレードは行われる場合があります
- ロールバックの注意点: ロールバックの開始時点で実行中のタスクは直ちに終了し、再試行の設定に従って再スケジュールされます。アップグレード時のデータベース移行で削除された列は、ロールバックで列は戻っても中のデータは復元されません
- 展開状況: 10月13日に始まったリリースは展開中で、記載の変更や機能が一部のリージョンではまだ使えない場合があります
💼 こんな場面で活用できます(ユースケース)
データパイプラインを Managed Airflow で運用しているデータエンジニアが、新しい DAG を開発モード環境で試し、業務時間外は休止させておく使い方ができます。Airflow のバージョンアップ後に一部の DAG が動かなくなった場合は、ロールバックで以前のビルドに戻せます。
✨ 導入メリット
- 開発用の環境を必要なときだけ動かせるため、検証環境のコスト最適化につながります
- アップグレードを元に戻す手段ができ、バージョンアップの計画を立てやすくなります
- スケジューラの指標やデータベース保持のログが増え、環境の状態を把握しやすくなります
🤔 判断観点
自組織の利用状況に照らして、以下の観点をご確認いただくとよいでしょう。XIMIX として一律の対応を推奨するものではなく、状況に応じたご判断の材料としてご参照ください。
- サポート終了ビルドの利用有無: 上記の8つのバージョン・ビルドで動いている環境があるかを確認し、サポート対象のビルドへのアップグレード時期を検討します
- メンテナンス除外期間中の変更計画: 11月16日〜12月2日のメンテナンス除外期間と、自社のアップグレードや変更作業の予定との関係を確認します
- ロールバックの対象: ロールバックは展開中で、対象となるアップグレード元・先のビルドにも条件があります。自社の環境のリージョンとビルドが条件を満たすかを公式ドキュメントで確認します
- 開発モードの使い方: 開発モード環境は本番に使えないため、既存の検証用環境を置き換えるか、新しく用意するかを検討します
📚 公式ソース
- 製品ドキュメント: Create environments - Development mode(Managed Airflow)
- 製品ドキュメント: Hibernate environments(Managed Airflow)
- 製品ドキュメント: Upgrade environments - Rollback(Managed Airflow)
- 製品ドキュメント: Configure database retention policy(Managed Airflow)
- 製品ドキュメント: Versioning overview - Version deprecation and support(Managed Airflow)
- 製品ドキュメント: Managed Airflow version list
- 製品ドキュメント: Maintenance windows and exclusions - Exclusions(GKE)
- リリースノート: Google Cloud release notes - October 13, 2026
- リリースノート: Google Cloud release notes - October 14, 2026
6. Lakehouse — Dataproc Metastore からのメタデータ移行と Hive カタログ エンドポイントが一般提供に(GA・2026年10月14日)
Lakehouse(旧 BigLake。オープンな形式のデータを BigQuery やオープンソースのエンジンから共通に扱うためのサービス)で、2件の機能が一般提供(GA)になりました。Dataproc Metastore からのメタデータ移行と、Lakehouse ランタイム カタログの Apache Hive カタログ エンドポイントです。
🔍 何が変わったのか
- メタデータ移行: Dataproc Metastore のサービスから、Lakehouse の Apache Iceberg REST カタログ エンドポイントまたは Hive カタログ エンドポイントへ、メタデータを移行できます。一度だけの移行(バックフィル)と、宛先に書き込まずに検証するドライランを、コンソール、gcloud CLI、REST API から実行できます
- 移行は一回限りのバックフィルで、移行後に元のサービスで発生した変更は自動では同期されず、反映するには移行を再実行します。Dataproc Metastore 側のテーブルやデータベースの権限も移行されません
- Hive カタログ エンドポイント: サーバーレスの共通メタデータ層として使え、Apache Spark、Apache Hive、BigQuery の間でデータを共有し、まとめてクエリできます。Spark で作成したテーブルを、設定後に BigQuery から直接クエリできます
- Hive カタログ エンドポイントが扱うのは標準的な Hive・Spark のテーブルで、Apache Iceberg のテーブルは対象外です。ユーザー定義関数やトランザクションなど、Hive Metastore の一部の機能には対応していません
💼 こんな場面で活用できます(ユースケース)
Dataproc Metastore で Spark や Hive のテーブル定義を管理しているデータ基盤の担当者が、メタデータの管理先を Lakehouse に移す場面で使えます。ドライランで移行の結果を事前に確かめてから、本番の移行を実行できます。
✨ 導入メリット
- 公式ドキュメントによると、Hive カタログ エンドポイントにより、オープンソースのワークロード向けに Hive Metastore を自前で運用する必要がなくなります
- Spark で作ったテーブルを BigQuery から分析でき、Spark・Hive・BigQuery の間で同じデータを共有できます
- 移行機能が GA となり、既存の Dataproc Metastore からの移行を本番の計画に組み込めます
📚 公式ソース
- 製品ドキュメント: Migrate metadata from Dataproc Metastore to Lakehouse
- 製品ドキュメント: About the Hive catalog endpoint(Lakehouse)
- 製品ドキュメント: Set up Spark and Hive with the Lakehouse runtime catalog
- リリースノート: Google Cloud release notes - October 14, 2026
7. BigQuery — 会話型分析のエージェントを Gemini Enterprise で公開可能に、複数プロジェクトやデータセット単位の会話、回答のエクスポートにも対応(GA・2026年10月14日〜16日)
BigQuery の会話型分析(conversational analytics。自然な言葉で質問するとデータエージェントが分析して回答する機能)で、4つの更新がありました。Gemini Enterprise へのエージェントの公開、複数プロジェクトやデータセットを対象にした会話、回答の PDF・CSV へのエクスポートが一般提供(GA)となり、カナダの2リージョンでも使えるようになりました。
🔍 何が変わったのか
- Gemini Enterprise での公開(10月14日・GA): BigQuery で作成したデータエージェントを Gemini Enterprise に公開できます。公式ドキュメントでは Agent Registry を使った公開が推奨されており、データエージェントの保存リージョンをデータソースと Agent Gateway の構成に合わせる必要があります。利用者には Gemini Data Analytics Data Agent User ロールが必要で、初回に一度だけ OAuth のサインインで BigQuery への認証を行います
- 複数プロジェクト・データセットとの会話(10月14日・GA): エージェントのページで複数のプロジェクトを選ぶと、選んだプロジェクトのすべてのデータソースを対象に会話できます。データセットを選んで会話を始めると、データエージェントはそのデータセットのすべてのテーブルを参照し、必要に応じてテーブルを結合します
- 回答のエクスポート(10月15日・GA): テキスト、可視化、表、引用を含む回答を PDF または CSV で保存できます。表ごとの行数の上限は、PDF が20行、詳細 PDF が1,000行、CSV が5,000行です
- 対応リージョンの追加(10月16日): northamerica-northeast1(モントリオール)と northamerica-northeast2(トロント)で利用できるようになりました
💼 こんな場面で活用できます(ユースケース)
データ分析の担当者が売上や在庫のデータエージェントを作り、Gemini Enterprise を通じて営業部門や経営層に提供する場面で使えます。利用者は普段使う Gemini Enterprise の画面からデータに質問でき、得られた回答を PDF にして会議資料に添付できます。
✨ 導入メリット
- BigQuery の画面を使わない部門の担当者にも、データエージェントを Gemini Enterprise 経由で届けられます
- プロジェクトやデータセットを単位に会話を始められ、エージェントを個別に作らなくても横断的な質問ができます
- 回答を PDF・CSV で共有でき、分析結果を報告や後続の作業に回すまでの手間が減り、意思決定スピードの向上につながります
📚 公式ソース
- 製品ドキュメント: Create data agents - Publish a data agent in Gemini Enterprise(BigQuery)
- 製品ドキュメント: Create conversations - Converse using the Agents page(BigQuery)
- 製品ドキュメント: Create conversations - Datasets(BigQuery)
- 製品ドキュメント: Create conversations - Export an answer(BigQuery)
- 製品ドキュメント: Conversational analytics in BigQuery - Locations
- リリースノート: Google Cloud release notes - October 14, 2026
- リリースノート: Google Cloud release notes - October 15, 2026
- リリースノート: Google Cloud release notes - October 16, 2026
8. Cloud SQL for MySQL・PostgreSQL — 2026年4月18日より前に作成したインスタンスで Knowledge Catalog 連携が1日1回の同期になる既知の問題(2026年10月14日)
Cloud SQL for MySQL と Cloud SQL for PostgreSQL で、Knowledge Catalog(旧 Dataplex Universal Catalog。Google Cloud のデータカタログ・ガバナンスサービス)との連携に関する既知の問題が公開されました。2026年4月18日より前に作成したインスタンスで連携を有効にすると、同期がほぼリアルタイムではなく1日1回になります。
🔍 何が変わったのか
- 対象は、2026年4月18日より前に作成した Cloud SQL for MySQL と Cloud SQL for PostgreSQL のインスタンスです。これらのインスタンスで Knowledge Catalog との連携を有効にすると、既定の同期が1日1回になります
- 連携を有効にしたときのほぼリアルタイムの更新は、まだすべての既存インスタンスでは使えません。使えるようになった時点で、あらためて告知される予定です
⚠️ 使えなくなる機能 / 変更点
- 同期の頻度: 前週の10月9日付のリリースノートでは、2026年4月18日より前に作成した対象のインスタンス(MySQL 8.0 以降または PostgreSQL 14.0 以降で、新しいネットワーク アーキテクチャのもの)で連携を有効にすると、ほぼリアルタイムで同期されると案内されていました。今回の既知の問題では、2026年4月18日より前に作成したインスタンスで連携を有効にすると既定で1日1回の同期になり、ほぼリアルタイムの更新はまだすべての既存インスタンスでは使えないとされています
💼 こんな場面で活用できます(ユースケース)
業務データベースのテーブル定義を Knowledge Catalog で検索できるようにしているデータ管理部門が、カタログへの反映のタイミングを利用者に案内する場面で参照できます。スキーマを変更した直後にカタログを確認する運用がある場合は、1日1回の同期を前提に段取りを組めます。
✨ 導入メリット
- 同期の頻度に関する制約を事前に把握でき、カタログの更新を前提にした作業の段取りを調整できます
- 対象となるインスタンスの作成日が明示されているため、影響の有無を作成日から判断できます
🤔 判断観点
自組織の利用状況に照らして、以下の観点をご確認いただくとよいでしょう。XIMIX として一律の対応を推奨するものではなく、状況に応じたご判断の材料としてご参照ください。
- 影響範囲: Knowledge Catalog と連携している、または連携を予定している Cloud SQL インスタンスのうち、2026年4月18日より前に作成したものがあるかを確認します
- 運用への影響: カタログの情報をすぐに参照する必要がある業務があるか、1日1回の同期で足りるかを確認します
- 続報の確認: ほぼリアルタイムの同期が使えるようになった時点の告知を、Cloud SQL のリリースノートで確認します
📚 公式ソース
- 製品ドキュメント: Knowledge Catalog integration(Cloud SQL for MySQL)
- 製品ドキュメント: Knowledge Catalog integration(Cloud SQL for PostgreSQL)
- リリースノート(前週の案内): Google Cloud release notes - October 09, 2026
- リリースノート: Google Cloud release notes - October 14, 2026
9. Managed Service for Apache Kafka — Cloud Storage Sink コネクタの性能を改善(2026年10月14日)
Managed Service for Apache Kafka(ストリーミングデータの基盤 Apache Kafka のマネージドサービス)で、Cloud Storage Sink コネクタの性能が改善されました。
🔍 何が変わったのか
- メモリ不足(out-of-memory)によるエラーが減りました
- 処理できる最大のスループット(単位時間あたりのデータ量)が向上しました
- 小さなファイルが大量に作成される状態を避けるようになりました
💼 こんな場面で活用できます(ユースケース)
Managed Service for Apache Kafka のクラスタで Cloud Storage Sink コネクタを使い、Cloud Storage へデータを送っているデータエンジニアが対象です。
✨ 導入メリット
- メモリ不足によるエラーが減り、最大スループットも向上しています
- 小さなファイルが大量に作成される状態を避けられます
📚 公式ソース
- 製品ドキュメント: Create a Cloud Storage Sink connector(Managed Service for Apache Kafka)
- リリースノート: Google Cloud release notes - October 14, 2026
10. BigQuery — リージョンをまたいだテーブルのコピーが一般提供に(GA・2026年10月15日)
BigQuery で、テーブルを別のリージョンやマルチリージョンへコピーする機能が一般提供(GA)になりました。テーブルのほか、テーブル スナップショットやテーブル クローン、顧客管理の暗号鍵(CMEK)を使うテーブルもコピーできます。
🔍 何が変わったのか
- bq コマンド、API(コピージョブ)、クライアント ライブラリで、テーブルを別のリージョンへコピーできます。Google Cloud コンソールと TABLE COPY の DDL 文では実行できません
- ポリシータグが付いたテーブルはコピーできません。テーブルに設定した IAM ポリシーとタイムトラベルの情報はコピーされず、元のテーブルの有効期限はコピー先に引き継がれます
- テーブル クローンやスナップショットを別リージョンにコピーすると、テーブル全体の複製が作られ、追加のストレージ料金が発生します。複製の帯域は、プロジェクトごと・リージョンごとに物理容量で毎秒 2 GiB です
- リージョンをまたぐコピーには、BigQuery の料金に従った追加のデータ転送料金がかかります。コピージョブを途中で取り消した場合も料金は発生します
💼 こんな場面で活用できます(ユースケース)
米国のマルチリージョンに置いたテーブルを、東京リージョンでの分析用にコピーしたいデータエンジニアが使えます。データの保管場所を分けたい場合に、テーブル単位で別のリージョンに複製を作れます。
✨ 導入メリット
- bq コマンドや API のコピージョブで、テーブル単位に別リージョンへ複製できます。CMEK を使うテーブルもコピーの対象です
- GA となり、リージョンをまたぐデータ移行の手段として本番の計画に組み込めます
📚 公式ソース
- 製品ドキュメント: Manage tables - Copy tables across regions(BigQuery)
- リリースノート: Google Cloud release notes - October 15, 2026
11. BigQuery — GoogleSQL で列エイリアスを同じクエリ内で再利用可能に(GA・オプトイン・2026年10月15日)
BigQuery の GoogleSQL で、列エイリアス(SELECT 句で式に付ける別名)を同じクエリの中で再利用できるようになりました。本機能は一般提供(GA)で、利用するには事前に有効化が必要なオプトイン方式です。SELECT 句で定義した別名を、同じ SELECT リストや同じクエリブロックの WHERE 句ですぐに参照できます。
🔍 何が変わったのか
- 公式ドキュメントの例では、価格に係数を掛けて総額を求める式に別名を付け、WHERE 句でその別名を使って絞り込んでいます。同じ計算式を繰り返したり、サブクエリを使ったりする必要がありません
- Snowflake や Teradata などのデータウェアハウスの構文に対応するため、これらからのワークロードの移行を進めやすくなります
- 既定では無効です。管理者が DDL で reusable_column_aliases_mode オプションを on に設定し、組織単位またはプロジェクト単位で有効にします。BigQuery 管理者ロールなどの権限が必要です
- パイプ構文と Graph Query Language(GQL)では使えません。集計関数やウィンドウ関数を含む別名には、WHERE 句で使えないなどの制限があります
✨ 使えるようになる機能
- SELECT リスト内や WHERE 句での別名の参照により、長い計算式を何度も書かずにクエリを組めます
⚠️ 使えなくなる機能 / 変更点
- 名前の解決順序の変更: 公式ドキュメントでは、列エイリアスを有効にすると、クエリ内の名前の解決順序が変わると注意されています。サブクエリの別名が外側のクエリの列と同じ名前の場合、ユーザー定義関数の引数やスクリプトの変数と同じ名前の場合に、有効化の前後で結果が変わる例が示されています
- テーブルの既存の列は別名より優先されるため、公式ドキュメントでは別名に重複しない名前を付けることが推奨されています
💼 こんな場面で活用できます(ユースケース)
Snowflake や Teradata から BigQuery へ移行を進めているデータエンジニアが、別名を参照する既存の SQL を書き換える量を減らす場面で使えます。日常的に分析用の SQL を書く担当者にとっても、計算式を繰り返さずに済むため、クエリが読みやすくなります。
✨ 導入メリット
- 他のデータウェアハウスからの移行で、SQL の書き換え作業を減らせます
- 同じ計算式の繰り返しが減り、クエリの読みやすさと保守のしやすさが上がります
🤔 判断観点
自組織の利用状況に照らして、以下の観点をご確認いただくとよいでしょう。XIMIX として一律の対応を推奨するものではなく、状況に応じたご判断の材料としてご参照ください。
- 有効化の範囲: 組織全体で有効にするか、移行プロジェクトなど特定のプロジェクトに限るかを検討します
- 既存クエリへの影響: 有効化する範囲のプロジェクトで、名前が重なるサブクエリ・ユーザー定義関数・スクリプトの変数を使ったクエリがあるかを確認し、有効化の前後で結果を比べる検証を行うかを検討します
- 移行計画との関係: 他のデータウェアハウスからの移行を予定している場合、別名を参照する SQL がどの程度あるかを洗い出します
📚 公式ソース
- 製品ドキュメント: Column aliases(BigQuery)
- 製品ドキュメント: Column aliases - Enabling column aliases(BigQuery)
- リリースノート: Google Cloud release notes - October 15, 2026
12. Dataflow — Auto VM Selection が第4世代の Compute Engine マシンシリーズに対応(2026年10月15日)
Dataflow(ストリーミング・バッチのデータ処理パイプラインを実行するサービス)の Auto VM Selection が、第4世代の Compute Engine マシンシリーズに対応しました。Auto VM Selection は、ワーカーのマシンタイプを1種類に固定せず、条件に合う利用可能なマシンタイプから選んで確保する機能です。
🔍 何が変わったのか
- Auto VM Selection が有効な場合、Dataflow は性能向上のため、N4 や C4 などの第4世代のマシンを優先して選びます
- 起動時に第4世代のマシンが使えない場合は、N2 や E2 など広く提供されている第2世代のマシンファミリーへ自動で切り替え、ジョブの開始が遅れないようにします
- パイプラインのステップに CPU 数やメモリ量のリソースヒント(必要なリソースの目安)を指定すると、Auto VM Selection が有効になります
- Dataflow Prime、Confidential VM、GPU・TPU を使う場合などは無効になります。ディスクの種類を指定すると、第2世代のマシンに限定されます
💼 こんな場面で活用できます(ユースケース)
Dataflow でデータパイプラインを運用し、特定のマシンタイプの在庫不足でジョブの起動が遅れたり失敗したりした経験があるデータエンジニアが使えます。リソースヒントで必要な CPU 数とメモリ量を指定しておけば、確保できるマシンでジョブを開始できます。
✨ 導入メリット
- 第4世代のマシンを優先して使えるため、パイプラインの処理性能の向上が見込めます
- 第4世代が使えないときは第2世代に切り替わるため、リソースの確保を待つことによるジョブの遅延を減らせます
- 公式ドキュメントでは、細かく調整したジョブでは性能が下がる場合があるとして、一部のジョブで先に試すことが推奨されています。段階的に適用範囲を広げる進め方が取れます
📚 公式ソース
- 製品ドキュメント: Auto VM Selection(Dataflow)
- リリースノート: Google Cloud release notes - October 15, 2026
その他のアップデート
このほか、以下の更新がありました。
- Agent Platform Workbench(2026年10月12日): pyOpenSSL と cryptography のバージョンの不一致により、gcloud と gsutil が AttributeError で読み込めない問題が修正されました。このほか、上流の依存パッケージの最新版への更新と、20261011.00_p0 リリースの告知がありました
- Managed Service for Apache Kafka(2026年10月12日): サービスレベル契約(SLA)の対象に Produce API が加わりました(Managed Service for Apache Kafka Service Level Agreement)
- Looker(2026年10月12日): Looker (Google Cloud core) で、Looker 26.18 以降を使うインスタンスを対象に Workforce Identity Federation が Preview として使えるようになりました。外部の ID プロバイダを使ってユーザーが認証できます
- BigQuery(2026年10月13日): BigQuery の生成 AI 関数で gemini-4-argon モデルが使えるようになりました。本モデルは一般提供(GA)です(Generative AI overview - Locations)
- Cloud Storage(2026年10月13日): Storage Insights のデータセットに Object Contexts Catalog ビュー(object_contexts_catalog_view)が含まれるようになり、オブジェクト コンテキストを BigQuery で分析できます(Object contexts catalog、Analyze object contexts)
- Looker(2026年10月15日): 10月9日に告知された Looker 26.18 の機能について、Looker (Google Cloud core) インスタンスでの有効化が始まりました(Looker release notes)
まとめ
2026年10月12日〜18日のデータ分析カテゴリでは、BigQuery の会話型分析で Gemini Enterprise へのエージェント公開と回答のエクスポートが一般提供(GA)となり、AI.AGG 関数も output_schema 引数とあわせて GA になりました。データの取り込みと移動の面では、Data Transfer Service の増分転送、リージョンをまたぐテーブルのコピー、Lakehouse への Dataproc Metastore 移行が GA となっています。
既存の運用に関係する項目として、新しいプロジェクトでの Cloud SQL の接続方式の既定値変更、Managed Airflow の8つのバージョン・ビルドのサポート終了と11月16日〜12月2日のメンテナンス除外期間、Cloud SQL と Knowledge Catalog の連携に関する既知の問題があります。列エイリアスはオプトインのため、有効化する前に既存クエリへの影響を確認する観点も記載しました。自社の利用状況に該当する項目からご確認ください。
関連 XIMIX 記事
Google Cloud アップデート情報をシリーズでご覧になりたい方は、アップデート情報一覧から過去の記事もご確認いただけます。
- 超簡単!Gemini EnterpriseでBigQueryをデータソースにしてみる
- [Google Cloud Next '25 Las Vegas] セッション参加レポート: BigQueryの地理的冗長性を確保するには?
XIMIX からのご案内
XIMIX(サイミクス)は NI+C が運営する Google Cloud プレミアパートナーサービスです。Google Cloud / Google Workspace の導入・活用支援、データ活用、AI 活用などをご支援しています。本記事で取り上げた BigQuery や Managed Airflow、Cloud SQL、Dataform を活用したデータ基盤の構築・移行・運用にご関心がありましたら、お気軽にご相談ください。
お問い合わせはこちら
- XIMIX について: https://ximix.niandc.co.jp/about-ximix
参考資料
- Google Cloud Release Notes: https://cloud.google.com/release-notes
- 2026-10-12: Google Cloud release notes - October 12, 2026
- 2026-10-13: Google Cloud release notes - October 13, 2026
- 2026-10-14: Google Cloud release notes - October 14, 2026
- 2026-10-15: Google Cloud release notes - October 15, 2026
- 2026-10-16: Google Cloud release notes - October 16, 2026
- BigQuery リリースノート: https://cloud.google.com/bigquery/docs/release-notes
執筆者紹介